인공지능과 딥러닝의 세계를 떠받치는 가장 근본적인 모델을 하나 뽑으라면 단연 퍼셉트론(Perceptron) 일 것이다.
오늘은 그 퍼셉트론에 대해 공부해보고자 한다.
1. 개념
퍼셉트론은 1957년 프랭크 로젠블랫(Frank Rosenblatt)이 고안한,
인간의 뇌를 구성하는 신경세포 '뉴런'을 모방한 최초의 인공 신경망 모델이다.
뉴런이 여러 전기 신호를 받아 종합한 뒤, 특정 기준을 넘으면 다음 뉴런으로 신호를 전달하는 것처럼,
퍼셉트론도 여러 데이터를 입력받아 하나의 결정을 내린다.
퍼셉트론은 여러 증거(data)를 종합해 '참' 또는 '거짓'이라는 단순하지만 중요한 결정을 내린다.
마치 문지기가 여러 정보를 종합해서 방문객을 '통과'시킬지 '거부'할지 결정하는 것과 비슷하다.
2. 작동 원리
퍼셉트론의 작동 방식은 크게 3가지 요소로 구성된다.
1. 입력 (Inputs)
모델이 결정을 내리는 데 필요한 '정보'들이다.
예를 들어, 문지기가 "이 사람이 파티에 들어올 자격이 있는가?"를 판단한다면 다음과 같은 정보를 입력받을 것이다.
- 초대장을 가지고 있는가? (x1)
- 드레스 코드를 맞췄는가? (x2)
- 신분이 확실한가? (x3)
2. 가중치 (Weights)와 편향 (Bias)
모델에게 모든 정보가 똑같이 중요하지는 않다.
- 가중치(Weights): 각 정보의 '중요도'를 나타낸다. '초대장 소지 여부(x1)'는 '드레스 코드(x2)'보다 훨씬 중요하므로 더 높은 가중치를 갖는다. 이 가중치가 바로 퍼셉트론이 학습을 통해 찾아내야 할 핵심 값이다.
- 한마디로 입력신호가 결과인 출력에 주는 영향도를 조절하는 매개변수.
- 편향(Bias): 문지기의 '기본적인 성향'이라고 보면 된다. 편향이 높으면 그만큼 깐깐한 문지기라 웬만해서는 잘 통과시키지 않을 것이다. 반면, 편향이 낮다면 대부분 쉽게 통과시키는 유한 문지기라고 생각하면 될 것이다.
- 즉, Bias가 높을수록 분류의 기준이 엄격하다는 소리.
3. 출력 (Output)
모델의 최종적인 결과물이다.
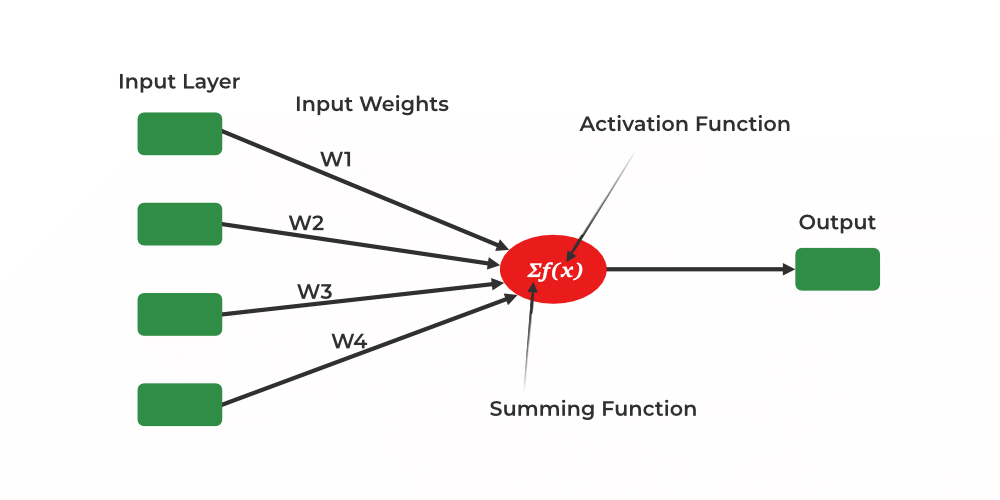
- 가중합 계산: 각각의 정보(입력)에 그 정보의 중요도(가중치)를 곱한 값들을 모두 더한다.
- 총점 = (정보1 * 중요도 1) + (정보 2 * 중요도 2) +...
- 최종 결정: 이 총점에 자신의 기본 성향(편향)을 더한 최종 점수가 자신만의 기준점(보통 0)을 넘으면 "통과(1)" 결정을 내리고, 넘지 못하면 "거부(0)" 결정을 내린다. 이 마지막 결정 단계를 "활성 함수(Activation Function)"라고 부른다.
위 과정을 그림으로 요약하면 다음과 같다.
4. 수식
퍼셉트론의 연산 과정을 수식으로 다시 한번 정리해 보자.
- i번째 엣지는 Xi와 Wi를 곱해 출력 노드로 전달된다.
- 0번째 입력 노드 X0은 1인 Bias 노드이다.
- 출력 노드는 d+1개의 곱셈 결과를 모두 더한 s를 계산하고 활성 함수(activation function)를 적용한다.

여기서 T(타우)는 활성 함수를 의미한다.
즉, o = T(s)의 의미는 "출력 o는 s에 활성함수를 적용한 것"이다.
- 활성함수는 뉴런을 활성화하는 과정을 모방한 것
- 퍼셉트론은 활성 함수로 '계단 함수' 사용 (s가 0보다 크면 1, 그렇지 않으면 -1 출력)
따라서 퍼셉트론은 특징 벡터를 1 또는 -1로 변환하는 장치, 즉 '이진 분류기'라고 표현할 수 있다.
병원에 온 사람을 '정상'과 '환자'로 구분하는 것으로 생각하면 되겠다.
이를 행렬로 표현하면
- w와 x는 1*d의 행렬 (x의 전치 행렬 xT는 d*1 행렬)
- wxT는 1*1 행렬로서 스칼라
- w0은 bias 값
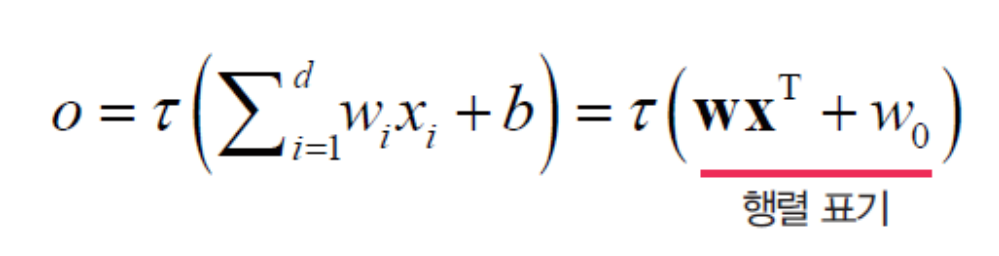
정리하면 퍼셉트론은
여러 입력을 받아 가중치를 고려하여 하나의 점수를 계산한 뒤,
그 점수가 특정 기준을 넘는지 아닌지에 따라 최종 결정을 내리는
간단하면서도 정확한 의사결정 모델
이라고 할 수 있다.
퍼셉트론은 선형으로 국한된다.
3. 학습 방법
퍼셉트론의 놀라운 점은 학습 능력에 있다.
처음에는 경험 없는 신입이 엉터리 가중치로 판단을 내린다.
하지만 자신이 내린 결정과 실제 정답을 비교하면서, 실수로부터 배워 정답을 맞혀 나간다.
그럼 대체 학습을 어떤 식으로 하는가?
실제 상황에서는 가중치가 따로 주어지지 않는다.
데이터만 주어지므로, 학습 알고리즘을 통해 가중치(w0, w1, w2,..., wd)를 알아내야 한다.
이해하기 쉽도록 사람의 학습 알고리즘부터 살펴보자.
다음은 사람이 수영을 학습하는 과정을 알고리즘 형식으로 기술한 것이다.
적절한 동작을 취한다.
while(true)
    동작에 따라 수영을 하고 평가한다.
    if(만족스러움) break
    더 나은 방향으로 동작을 수정한다.
동작을 기억한다.
이를 더 수학적으로 기술하면
초기 동작 벡터 w = (팔 돌리는 속도, 팔꿈치 각도, 팔과 귀의 거리)를 초기화한다.
while(true)
    w에 따라 수영을 하고 동작 w의 점수 J(w)를 계산한다.
    if (J(w)가 만족스러움) break
    더 나은 방향 Δw를 계산한다.
    w = w + Δw
w를 기억한다.
퍼셉트론도 "조금씩 나은 방향을 찾아 개선해 나가는 절차를 밟는" 사람의 학습과 동일한 방식을 따른다.
입력: Train data sets
출력: 최적의 매개변수 값 -> "가중치"

난수로 매개변수 벡터 w를 초기화

while(true)
    w에 따라 데이터를 인식하고 손실 함수 J(w)를 계산
    if(J(w)가 만족스러움) break
    손실 함수 값을 낮추는 방향 Δw를 계산
    w = w + Δw
w를 저장한다.
따라서 학습을 하려면 얼마나 '틀렸는지' 알아야 한다.
1단계
그러기 위해 '손실 함수'를 통해 예측이 실제 정답과 얼마나 다른지를 측정해 하나의 '벌점' 점수로 알려준다.
- 규칙 1: 모든 문제를 맞히면 벌점은 0점이다.
- 규칙 2: 틀린 문제가 많을수록 벌점은 커진다.
퍼셉트론은 틀린 데이터에 대해서만 벌점을 계산하는 손실 함수 J(w)를 사용한다.
- 1. w가 훈련 집합에 있는 샘플을 모두 맞히면(정확률 100%) J(w)는 0이다.
- 2. w가 틀리는 샘플이 많을수록 J(w)의 값이 크다.
수식으로 표현하면 다음과 같다.

- I는 w가 틀리는 샘플의 집합이다. (정답을 맞힌 샘플은 계산에 전혀 포함되지 않는다는 의미)
- 손실 값은 틀렸을 때마다 더해져야 하므로, 더해지는 값 -y(wxT)는 항상 양수여야 한다.
- x가 +1 부류인데 (y = 1이라면) 틀린 경우
- 틀렸다는 것은 모델이 -1로 예측했다는 의미이므로 (wxT) 값은 음수다. 이때 -y(wxT)는 양수가 된다.
- x가 -1 부류인데 (y = -1이라면) 틀린 경우
- 틀렸다는 것은 모델이 +1로 예측했다는 의미이므로 (wxT) 값은 양수다. 이때 -y(wxT)는 양수가 된다.
- 따라서 어떤 방식으로든 샘플을 틀리게 되면 더해지는 값은 항상 양수가 된다.
- x가 +1 부류인데 (y = 1이라면) 틀린 경우
2단계
벌점을 받았으니, 이제 이 벌점을 줄이는 방향으로 나아가야 할 것이다.
이때 사용되는 방법이 '경사 하강법(gradient descent)'이다.
경사 하강법의 흐름은 다음과 같다.
- 현재 위치에서 경사를 살핀다: 손실 함수 위의 한 지점에서 가장 가파른 경사(기울기, Gradient)를 계산한다.
- 경사의 반대 방향으로 이동한다: 가장 가파른 오르막길의 반대 방향이 바로 가장 빠른 내리막길이다. 그 방향으로 약간만 이동한다.
- 반복한다: 이 과정을 계속 반복하면 결국 손실이 가장 낮은 지점, 즉 모델의 성능이 최적인 지점에 도달하게 된다.
이해가 쉽게 아래 그림을 참고하자.
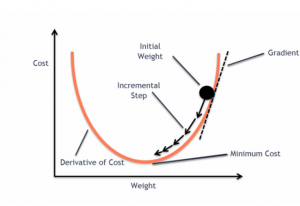
- 경사 하강법은 미분을 이용하여 최적해를 찾아가는 기법이다.
- 미분값 (∂J / ∂w)의 반대 방향이 최적해에 접근하는 방향이므로, 현재 w1이라고 가정할 때 -(∂J / ∂w)를 더하면 최적해에 가까워진다. (위 그림 참고)
- 이때 한 번에 얼마나 이동할지를 모르기 때문에, 이를 결정하는 보폭의 크기를 '학습률(Learning Rate) p'라고 한다.
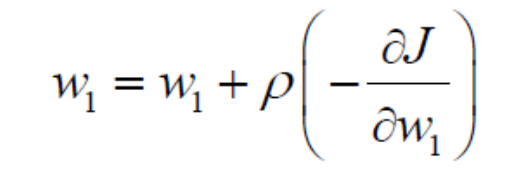
만약 매개변수가 여러 개라면 편미분으로 구한 그레이디언트를 사용한다.
그레이디언트 - '기울기'가 더 이상 숫자 하나가 아닌, 벡터라는 소리
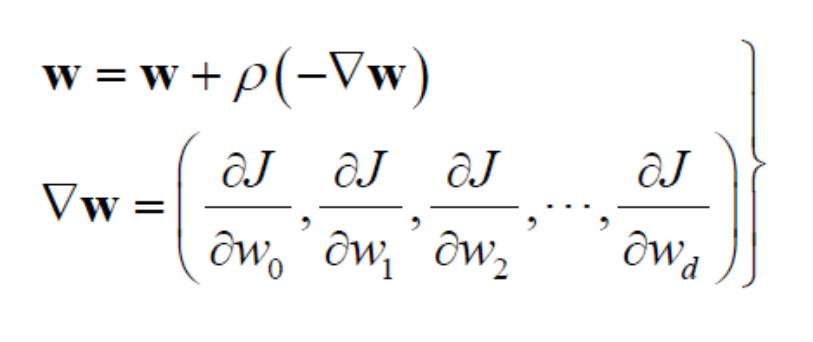
이제 이를 퍼셉트론에 적용해 보자.
3단계
좀 전에 구한 손실 함수 J(w) 식을 매개변수 wi로 편미분 하면 다음과 같다.
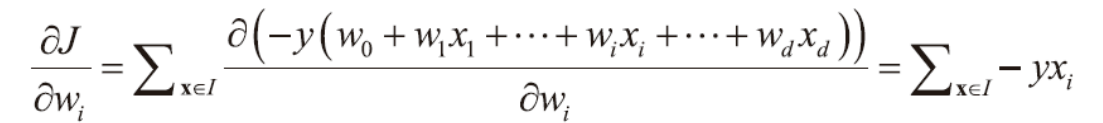
이를 정리하면
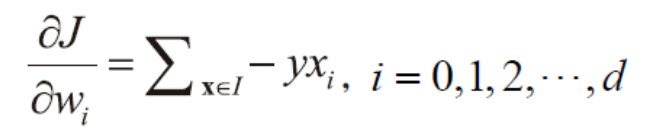
따라서 퍼셉트론의 학습 규칙은 다음과 같다.
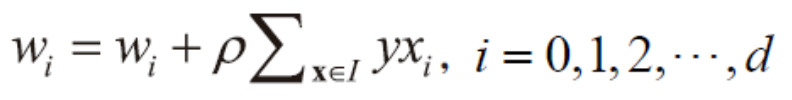
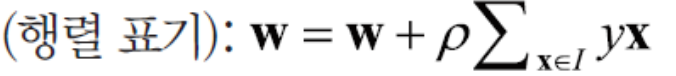
이 공식의 의미는
"만약 예측이 틀렸다면, 정답(y)과 입력(x)을 곱한 값만큼 가중치(w)를 수정하라."
로 해석할 수 있다.
이 간단한 규칙을 반복하여 퍼셉트론은 데이터에 대한 최적의 결정 경계선을 스스로 찾아 나가는 것이다.
4. 마치며
퍼셉트론은 데이터를 하나의 직선으로만 나눌 수 있다는 명확한 한계가 존재한다.
이 때문에 직선으로 나눌 수 없는 문제(XOR 문제)는 풀 수 없었다.
물론 이 단순한 퍼셉트론을 여러 층으로 쌓아 올려 '다층 퍼셉트론(Multi-Layer Perceptron, MLP)'을 만들었고,
이것이 바로 오늘날 우리가 아는 딥러닝의 시작이라고 볼 수 있다.
결론적으로 퍼셉트론은 단순하지만 '가중치', '학습', '손실 함수', '경사 하강법' 등
현대 인공지능의 거의 모든 핵심 아이디어를 품고 있는 중요한 모델이라고 할 수 있다.
'개발 > AI' 카테고리의 다른 글
| [AI] LangChain이란? (0) | 2026.09.13 |
|---|---|
| [AI] RAG란? - 검색 증강 생성의 개념과 동작 원리 이해하기 (0) | 2026.08.31 |