생성형 AI를 사용할 때 우리는 자연어로 질문을 입력하고 몇 초 뒤 자연스러운 답변을 받는다.
겉으로 보면 단순한 대화처럼 보이지만, 모델 내부에서는 문장을 토큰으로 나누고, 각 토큰을 벡터로 변환하고, 토큰 사이의 관계를 계산한 뒤 다음 토큰의 확률을 예측하는 과정이 반복된다.
이번 주차에서는 다음 질문을 중심으로 LLM의 구조를 살펴보았다.
컴퓨터는 어떻게 사람의 언어를 숫자로 표현하고,
문맥을 이해하며, 다음 단어를 생성할 수 있을까?
이를 이해하기 위해 소프트웨어 개발 방식의 변화에서 출발해 NLP의 발전 과정과 Transformer의 핵심 원리까지 정리해 본다.
1. Software 3.0과 LLM의 등장
소프트웨어를 만드는 방식의 변화
소프트웨어 개발 방식은 크게 세 단계로 구분할 수 있다.
| 구분 | 사람이 제공하는 것 | 기계가 수행하는 것 |
| Software 1.0 | 코드와 규칙 | 작성된 명령 실행 |
| Software 2.0 | 데이터와 학습 목표 | 모델의 가중치 학습 |
| Software 3.0 | 자연어 지시, 목표, 데이터 | 문제 해결 과정과 실행 방식 생성 |
Software 1.0: 규칙을 코드로 작성한다
전통적인 소프트웨어에서는 개발자가 프로그램의 동작을 코드로 직접 작성한다.
예를 들어 고객의 등급을 구분한다면 다음과 같이 규칙을 명시할 수 있다.
def classify_customer(purchase_amount: int) -> str:
    if purchase_amount >= 1_000_000:
        return "VIP"
    if purchase_amount >= 500_000:
        return "GOLD"
    return "NORMAL"
프로그램은 개발자가 작성한 조건과 명령에 따라 결정론적으로 동작한다.
같은 입력을 넣으면 항상 같은 결과가 나오며, 프로그램에 없는 규칙은 스스로 만들어 내지 못한다.
Software 2.0: 데이터를 통해 모델을 학습한다
머신러닝에서는 사람이 모든 규칙을 직접 작성하지 않는다.
대신 입력 데이터와 정답을 제공하고, 모델이 두 데이터 사이의 관계를 학습하도록 한다.
입력 데이터 + 정답
→ 학습 알고리즘
→ 가중치가 조정된 모델
예를 들어 스팸 메일 분류에서는 사람이 모든 스팸 표현을 조건문으로 작성하는 대신, 스팸과 정상 메일 데이터를 모델에 제공한다.
모델은 데이터에서 반복적으로 나타나는 표현과 패턴을 학습하여 새로운 메일이 스팸인지 예측한다.
Software 1.0이 함수를 직접 작성하는 방식이라면, Software 2.0은 데이터로부터 함수를 학습하는 방식이라고 볼 수 있다.
Software 3.0: 자연어로 목표를 전달한다
Software 3.0에서는 사람이 자연어로 목표와 조건을 설명하고, AI가 이를 바탕으로 작업을 수행한다.
자연어 지시 + 데이터 + 도구
→ LLM 또는 AI Agent
→ 코드, 문서, 판단, 실행 결과
예를 들어 웹 애플리케이션을 만들 때 모든 HTML, CSS, JavaScript 코드를 직접 작성하는 대신 다음과 같이 요청할 수 있다.
장애물을 피하며 점수를 획득하는
간단한 웹게임을 단일 HTML 파일로 만들어 줘.

속도 증가, 최고 점수 저장, 재시도 기능을 포함하고
모바일에서도 실행할 수 있도록 작성해 줘.
LLM은 이 자연어 요구사항을 해석해 코드 구조와 구현 방법을 제안한다.
Software 1.0·2.0·3.0 비교는 사람이 코드에서 데이터로, 다시 자연어 목표와 역할을 제공하는 방향으로 이동하고 있음을 보여준다.
자연어가 새로운 인터페이스가 된다
Software 3.0에서 가장 큰 변화는 자연어가 프로그래밍의 중요한 인터페이스가 되었다는 점이다.
기존 소프트웨어
코드 → 함수 → 프로그램

Software 3.0
자연어 → 프롬프트 → 모델 + Context
이 변화에 따라 개발자의 역할도 달라진다.
과거에는 정확한 코드를 작성하는 능력이 중심이었다면, 이제는 다음 능력도 중요해지고 있다.
- 해결해야 할 문제를 명확하게 정의하는 능력
- 필요한 데이터와 Context를 선별하는 능력
- AI가 사용할 도구와 작업 흐름을 설계하는 능력
- 생성된 결과를 검증하고 통제하는 능력
- 사람과 AI의 역할을 적절하게 나누는 능력
LLM은 단순한 텍스트 생성 도구가 아니라 추론 엔진, 지식 인터페이스, 자연어 컴파일러, Agent의 두뇌 역할을 수행하는 새로운 실행환경으로 볼 수 있다.
Software 3.0의 장점과 한계
Software 3.0은 개발 속도를 높이고 비개발자의 진입장벽을 낮출 수 있다. 결정론적인 코드는 기존 프로그램이 담당하고, 판단이 필요한 부분은 통계적 모델이 담당하는 혼합 구조도 만들 수 있다.
하지만 AI가 생성한 결과는 항상 정확하거나 최적이라고 보장할 수 없다.
- 모델 내부의 판단 과정을 완전히 설명하기 어렵다.
- 학습 데이터의 편향이 결과에 반영될 수 있다.
- 코드에 버그나 보안 문제가 포함될 수 있다.
- 같은 지시에도 결과가 달라질 수 있다.
- 겉으로는 정상적으로 보이지만 잘못된 결과를 만들 수 있다.
따라서 Software 3.0은 사람이 사라지는 개발 방식이 아니라, 사람과 AI가 함께 지능형 소프트웨어를 만드는 방식에 가깝다.
2. NLP는 어떻게 문장을 숫자로 바꿔 왔을까?
컴퓨터는 사람처럼 문장을 직접 이해하지 못한다.
모델이 언어를 처리하려면 먼저 단어와 문장을 숫자로 변환해야 한다. 이 과정이 자연어 처리, 즉 NLP의 중요한 출발점이다.
Corpus와 Vocabulary
Corpus는 모델이 사용하는 전체 문서나 문장의 집합이다.
예를 들어 뉴스 기사 10만 건을 수집했다면 이 뉴스 데이터 전체가 Corpus가 된다.
Vocabulary는 Corpus에서 모델이 처리할 단어나 토큰을 정리한 목록이다.
Corpus
→ 문장과 단어 수집
→ 중복 및 불필요한 표현 처리
→ Vocabulary 생성
→ 각 토큰을 숫자로 변환
자연어를 기계가 이해하려면 수치로 변환해야 하며, 이를 위해 Corpus와 Vocabulary가 필요하다고 설명한다.
One-hot Vector
가장 단순한 방법은 Vocabulary의 각 단어에 고유한 위치를 부여하는 것이다.
Vocabulary가 다음과 같다고 하자.
1: 사과
2: 바나나
3: 오렌지
4: 가방
각 단어는 다음처럼 표현할 수 있다.
사과   = [1, 0, 0, 0]
바나나 = [0, 1, 0, 0]
오렌지 = [0, 0, 1, 0]
가방   = [0, 0, 0, 1]
이 방식은 단어를 숫자로 구분할 수 있지만 단어 간 의미 관계는 표현하지 못한다.
사과는 오렌지와 의미적으로 가깝지만, One-hot Vector에서는 두 단어 사이의 관계가 사과와 가방의 관계와 다르지 않다.
Bag of Words와 TF-IDF
Bag of Words는 문장이나 문서를 각 단어의 출현 횟수로 표현한다.
문서: "사과 바나나 사과"

Vocabulary: [사과, 바나나, 오렌지]

BoW Vector: [2, 1, 0]
문서에 어떤 단어가 몇 번 등장했는지는 알 수 있지만, 단어가 등장한 순서는 알 수 없다.
다음 두 문장은 다른 의미를 가지지만 BoW 표현에서는 같아질 수 있다.
나는 너를 좋아한다.
너는 나를 좋아한다.
TF-IDF는 단순 빈도에 문서 전체에서의 희소성을 함께 반영한다.
- TF: 현재 문서에서 많이 등장하는 단어인가?
- IDF: 다른 문서에서는 상대적으로 드물게 등장하는 단어인가?
모든 문서에 자주 등장하는 조사나 일반적인 표현보다 특정 문서에만 집중적으로 나타나는 단어에 높은 중요도를 부여한다.
N-gram으로 일부 순서를 보존한다
N-gram은 연속된 N개의 단어를 하나의 묶음으로 처리한다.
문장: I am studying language models.

Bigram:
I am
am studying
studying language
language models
BoW보다 단어 순서를 일부 반영할 수 있지만 N이 커질수록 가능한 조합의 수가 급격하게 증가한다.
Vocabulary가 커지고 데이터가 희소해지므로 긴 문맥을 처리하기에는 한계가 있다.
빈도 기반 표현의 근본적인 한계
One-hot Vector, BoW, N-gram, TF-IDF는 특정 작업에서 여전히 유용하다.
특히 문서 검색이나 주제 분류처럼 단어 출현 여부가 중요한 작업에 적합하다.
그러나 언어의 의미와 문맥을 다루기에는 다음 문제가 있다.
- 단어 순서를 충분히 표현하지 못한다.
- Vocabulary가 커질수록 벡터 차원이 지나치게 커진다.
- 대부분의 값이 0인 희소 벡터가 만들어진다.
- 동의어나 유의어의 관계를 표현하기 어렵다.
- 한 단어가 문맥에 따라 달라지는 의미를 처리하지 못한다.
이 한계를 해결하기 위해 단어를 밀집된 의미 벡터로 표현하는 Word Embedding이 등장했다.
분포가설: 단어의 의미는 주변 문맥에 있다
분포가설은 다음 아이디어에서 출발한다.
비슷한 문맥에서 사용되는 단어는 비슷한 의미를 가진다.
예를 들어 다음 문장을 살펴보자.
같은 부모에게서 태어난 나이가 어린 형제를 동생이라고 부른다.
같은 부모에게서 태어난 나이가 어린 형제를 아우라고 부른다.
‘동생’과 ‘아우’ 주변에 등장하는 단어가 비슷하므로 두 단어의 의미도 유사하다고 추론할 수 있다.
즉, 사람이 직접 단어 사전을 만들지 않아도 대규모 문장 데이터에서 주변 단어의 분포를 학습하면 의미 관계를 추출할 수 있다.
Word2Vec과 Word Embedding
Word2Vec은 주변 단어를 이용해 중심 단어를 예측하거나, 중심 단어를 이용해 주변 단어를 예측하는 방식으로 학습한다.
문장:
You say goodbye and I say hello.

중심 단어: goodbye

주변 단어:
You
say
and
I
학습이 반복될수록 비슷한 문맥에서 등장하는 단어들이 벡터 공간의 가까운 위치에 배치된다.
이렇게 학습한 벡터에는 단순한 식별 번호가 아니라 의미 관계가 포함된다.
King - Man + Woman ≈ QueenWord Embedding은 다음 작업에 활용할 수 있다.
- 의미가 비슷한 단어 검색
- 문서 간 유사도 계산
- 추천 시스템
- 검색 결과 정렬
- 분류 모델의 입력
- RAG의 문서 검색
강의자료의 임베딩 공간 그림에서도 관련 있는 단어가 벡터 공간에서 가까운 군집을 형성하는 모습을 확인할 수 있다.
고정 임베딩에서 문맥 임베딩으로
Word2Vec과 같은 초기 임베딩에는 여전히 문제가 있다.
하나의 단어가 항상 하나의 고정된 벡터를 갖기 때문이다.
그는 은행에서 돈을 인출했다.
우리는 강둑에서 소풍을 했다.
영어의 bank는 첫 문장에서 금융기관이고, 두 번째 문장에서는 강둑이다.
고정 임베딩은 이 차이를 표현하기 어렵다.
Transformer 기반 모델은 주변 문맥을 함께 계산하여 같은 단어라도 문장에 따라 다른 벡터를 생성한다.
이를 Contextual Embedding이라고 한다.
bank + money + loan
→ 금융기관에 가까운 표현

bank + river + shore
→ 강둑에 가까운 표현
Contextual Embedding은 BERT와 GPT가 문장의 미묘한 의미 차이를 구분하는 기반이 되었다.
3. 언어모델은 왜 다음 단어를 예측할까?
Language Model의 역할
Language Model은 문장에 포함된 단어의 순서가 얼마나 자연스러운지 확률로 표현하는 모델이다.
또한 문장의 앞부분이 주어졌을 때 다음에 나올 단어를 예측할 수 있다.
퇴근 후 공항에 택시를 타고 갔는데
탑승 시간에 늦어서 결국 비행기를 ______.
모델은 이전 단어와 학습 데이터에 나타난 표현을 바탕으로 후보 단어의 확률을 계산한다.
놓쳤다: 0.72
탔다: 0.15
봤다: 0.08
기타: 0.05
다음 단어를 예측하는 과정이 단순해 보이지만, 정확한 예측을 위해서는 문법과 의미, 앞 문장의 내용과 상황을 종합적으로 이해해야 한다.
따라서 다음 토큰 예측 능력이 향상될수록 모델의 언어 이해 능력도 함께 높아진다.
RNN: 과거 정보를 순차적으로 전달한다
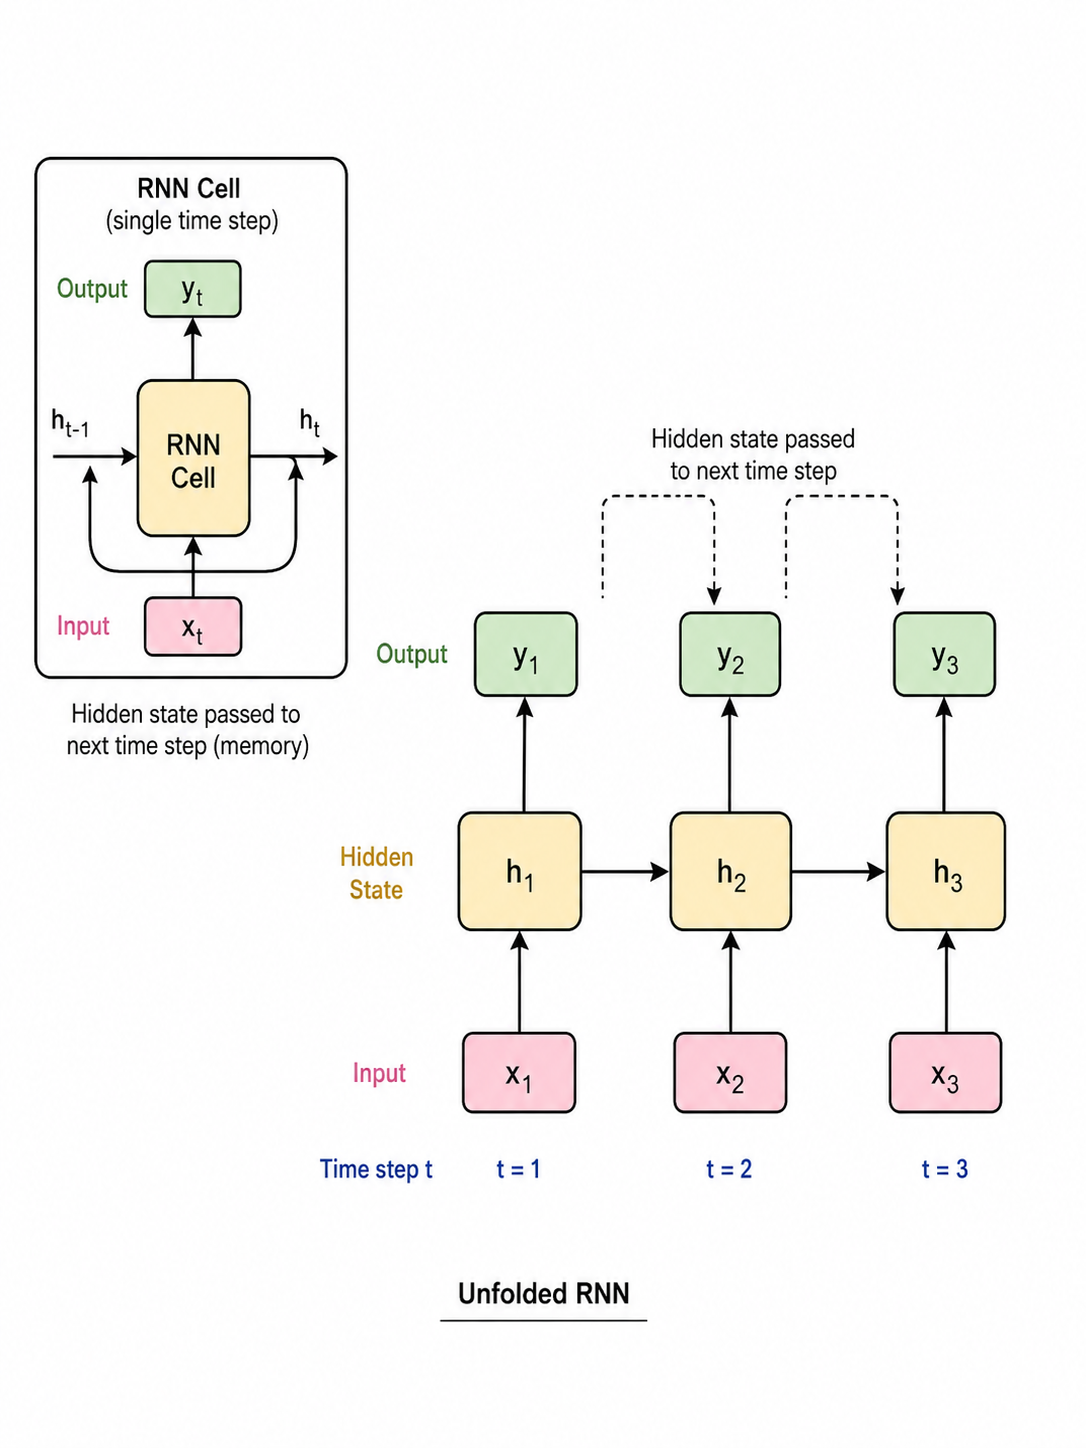
RNN은 문장을 첫 단어부터 순서대로 처리한다.
I → study → AI → hard각 시점에서는 현재 입력뿐 아니라 이전까지의 정보를 담은 Hidden State를 사용한다.
현재 Hidden State
= 현재 입력 + 이전 Hidden State
Hidden State는 앞서 읽은 단어의 정보를 다음 시점으로 전달하는 메모리 역할을 한다.
하지만 문장이 길어지면 오래된 정보가 뒤쪽까지 제대로 전달되지 못하는 문제가 발생한다.
이를 장기 의존성 문제라고 한다.
RNN 학습 과정에서 Gradient가 점점 작아져 초반 정보가 거의 학습되지 않는 Vanishing Gradient 현상도 발생할 수 있다.
LSTM과 GRU: 기억을 선택적으로 관리한다
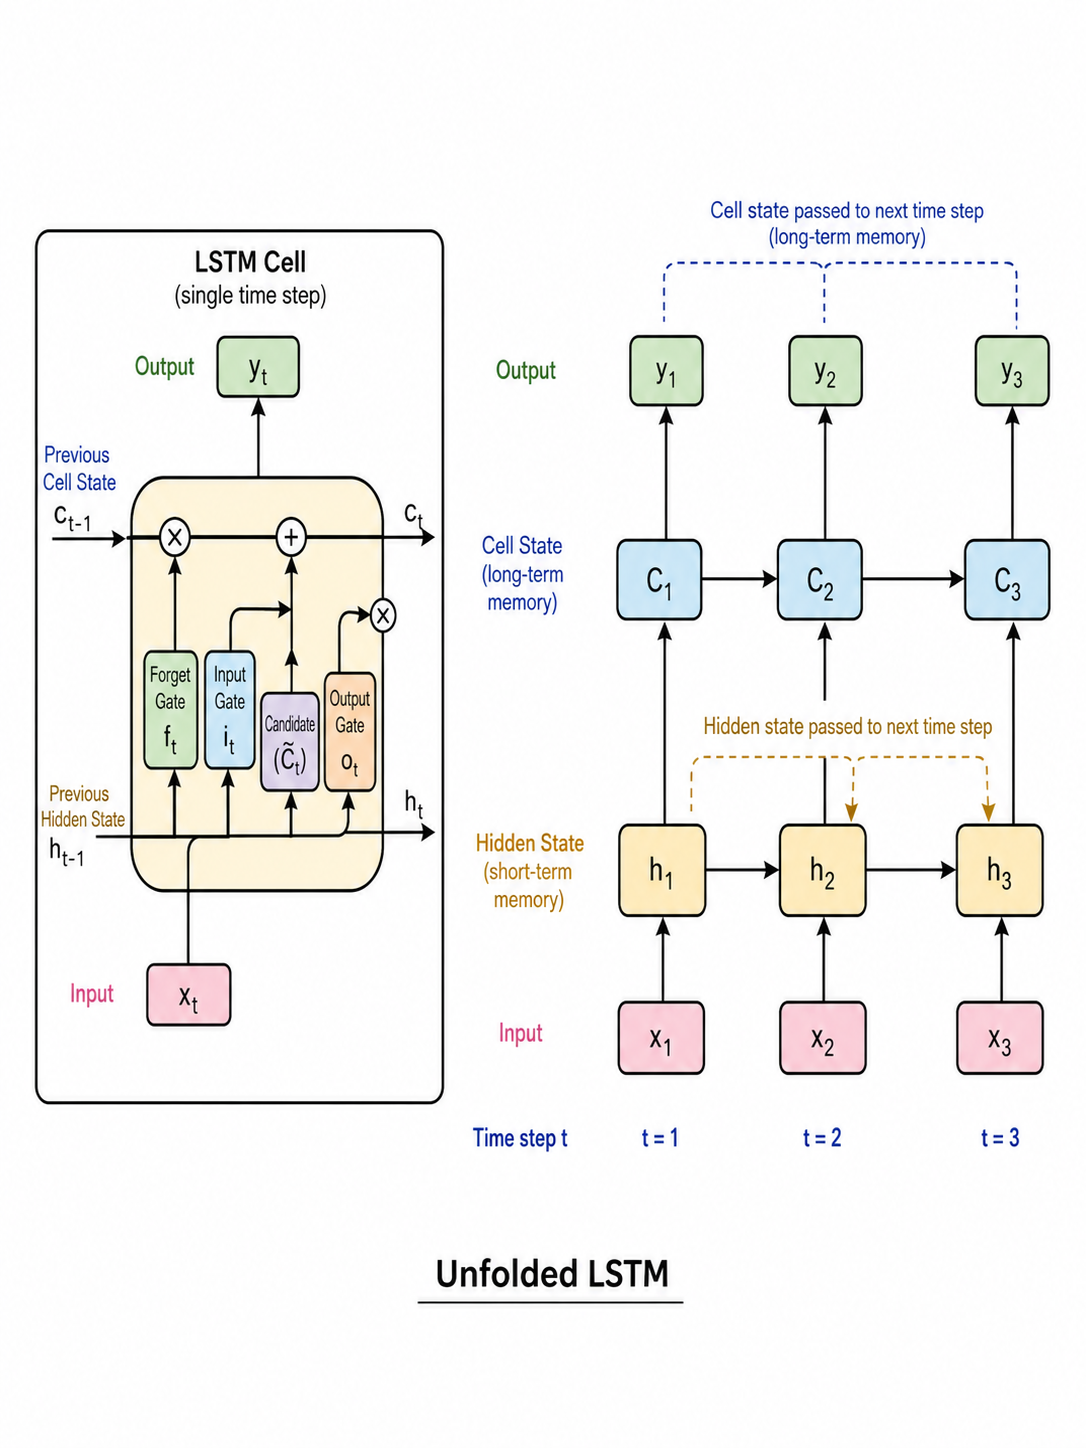
LSTM은 여러 Gate를 사용해 어떤 정보를 기억하고 어떤 정보를 버릴지 조절한다.
- Input Gate: 새로운 정보를 얼마나 받아들일 것인가?
- Forget Gate: 기존 기억을 얼마나 유지할 것인가?
- Output Gate: 현재 기억 중 무엇을 출력할 것인가?
GRU는 LSTM과 비슷한 목적을 가지지만 Gate 구조를 단순화해 연산량을 줄인다.
두 모델 모두 RNN의 장기 의존성 문제를 완화했지만 단어를 여전히 순차적으로 처리하기 때문에 병렬 학습이 어렵다.
Sequence-to-Sequence와 Context Vector
번역과 같이 입력 문장과 출력 문장이 서로 다른 작업에서는 Encoder와 Decoder 구조가 사용된다.
입력 문장
→ Encoder
→ Context Vector
→ Decoder
→ 출력 문장
Encoder는 입력 문장을 하나의 Context Vector로 압축한다.
Decoder는 이 벡터를 바탕으로 목표 문장을 생성한다.
하지만 긴 문장의 모든 정보를 하나의 고정된 벡터에 압축하면 앞부분의 정보가 손실될 수 있다.
문장 전체를 한 장의 작은 메모지에 모두 적어 Decoder에 전달하는 것과 비슷하다.
이 문제를 해결하기 위해 Decoder가 문장을 생성할 때마다 Encoder의 전체 출력 중 필요한 부분을 직접 참고하는 Attention이 등장했다.
Attention: 현재 필요한 단어에 집중한다
Attention의 핵심 아이디어는 간단하다.
출력 단어를 생성할 때 입력 문장의 모든 단어가 똑같이 중요한 것은 아니다.
영어 문장을 한국어로 번역한다고 하자.
특정 단어를 생성할 때 관련성이 높은 입력 단어에는 큰 가중치를 주고, 관련성이 낮은 단어에는 작은 가중치를 준다.
입력 단어
→ 관련성 점수 계산
→ Softmax로 가중치 변환
→ 중요한 정보 중심으로 결합
따라서 하나의 고정 Context Vector를 사용하는 대신, 출력 시점마다 필요한 정보가 반영된 새로운 Context Vector가 만들어진다.
Attention은 긴 문장의 정보 손실을 완화했지만 초기에는 RNN 기반 Encoder와 Decoder 위에 추가되는 구조로 사용되었다.
Transformer는 여기서 더 나아가 RNN을 제거하고 Attention만으로 전체 문장을 처리한다.
전이학습과 대규모 사전학습
과거에는 하나의 작업마다 별도의 모델을 학습하는 경우가 많았다.
번역 모델
요약 모델
분류 모델
질의응답 모델
전이학습은 대규모 데이터에서 미리 학습한 모델을 새로운 작업에 재사용하는 방식이다.
대규모 사전학습
→ 일반적인 언어 패턴 획득
→ 특정 작업에 적용 또는 미세조정
GPT의 이름도 이러한 구조를 반영한다.
- Generative: 텍스트 생성
- Pre-trained: 대규모 데이터로 사전학습
- Transformer: Transformer 아키텍처 사용
Transformer는 병렬 처리가 가능했기 때문에 훨씬 큰 데이터와 모델을 사용할 수 있게 했다.
이후 모델 크기, 데이터 규모와 계산량을 확장하는 Scaling이 LLM 발전의 중요한 동력이 되었다.
4. Transformer는 문맥을 어떻게 계산할까?
2017년 발표된 「Attention Is All You Need」는 RNN과 CNN 없이 Self-Attention만으로 시퀀스를 처리하는 Transformer를 제안했다.
당시의 RNN 계열 모델은 순차 처리 때문에 병렬화가 어렵고, 긴 문장의 관계를 학습하기 어렵다는 한계가 있었다.
Transformer는 모든 토큰 사이의 관계를 직접 계산해 이러한 문제를 해결했다.
Transformer의 전체 구조
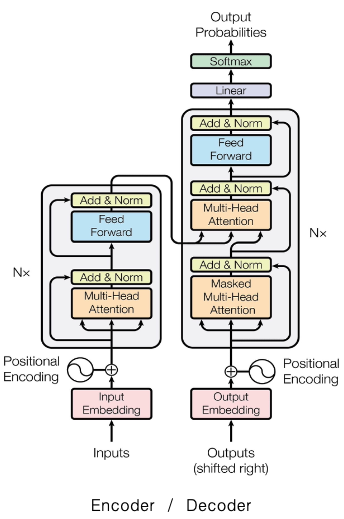
초기 Transformer는 번역을 위한 Encoder–Decoder 구조로 설계되었다.
Encoder
입력 문장을 읽고 각 토큰을 문맥이 반영된 벡터로 변환한다.
Token Embedding
+ Positional Encoding
→ Multi-Head Self-Attention
→ Add & Norm
→ Feed Forward
→ Add & Norm
Decoder
이미 생성된 토큰과 Encoder의 출력을 참고해 다음 토큰을 생성한다.
Output Embedding
+ Positional Encoding
→ Masked Multi-Head Self-Attention
→ Encoder–Decoder Attention
→ Feed Forward
→ Linear
→ Softmax
Transformer의 전체 구조도에서 Encoder는 입력 문장의 의미를 추출하고, Decoder는 인코딩된 정보와 이전 출력 토큰을 바탕으로 목표 문장을 생성한다.
Self-Attention의 핵심: Query, Key, Value
Self-Attention에서는 각 입력 토큰을 세 개의 벡터로 변환한다.
| Query | 현재 토큰이 찾고 있는 정보 | 나는 누구를 참고해야 하는가? |
| Key | 각 토큰이 가진 검색 기준 | 나는 어떤 정보와 연결되는가? |
| Value | 실제로 전달할 정보 | 최종적으로 어떤 내용을 가져갈 것인가? |
예를 들어 다음 문장이 있다고 하자.
I study AI hard.각 토큰의 입력 벡터에 서로 다른 가중치 행렬을 곱해 Q, K, V를 만든다.
Q = XWQ
K = XWK
V = XWV
여기서 X는 입력 토큰의 벡터 행렬이며, WQ·WK·WV는 학습되는 가중치다.
Attention Score 계산
Query와 Key의 내적을 계산하면 각 토큰이 다른 토큰과 얼마나 관련 있는지 나타내는 Score Matrix가 만들어진다.
Score = QKᵀScore Matrix의 (i, j) 값은 다음을 의미한다.
i번째 토큰이 자신의 문맥을 만들 때
j번째 토큰을 얼마나 참고해야 하는가?
관련성이 높을수록 내적값이 커진다.
강의자료의 Score Matrix 그림은 Q의 각 행과 K의 각 토큰이 매칭되면서 모든 토큰 쌍의 관계가 계산되는 과정을 보여준다.
왜 √dₖ로 나눌까?
벡터 차원이 커지면 내적값의 크기도 커질 가능성이 높다.
내적값이 지나치게 커지면 Softmax의 출력이 특정 토큰에 과도하게 몰리고, Gradient가 작아져 학습이 불안정해질 수 있다.
이를 방지하기 위해 Key 벡터의 차원 dₖ의 제곱근으로 나눈다.
Scaled Score = QKᵀ / √dₖ이후 Softmax를 적용해 각 행의 값을 확률 형태로 변환한다.
Attention Weight
= Softmax(QKᵀ / √dₖ)
Value와 결합해 문맥 벡터를 만든다
계산된 Attention Weight에 V를 곱한다.
Attention(Q, K, V)
= Softmax(QKᵀ / √dₖ)V
이 결과는 각 토큰이 다른 토큰의 정보를 중요도에 따라 섞어 만든 새로운 표현이다.
예를 들어 특정 토큰의 Attention Weight가 다음과 같다고 하자.
I     : 0.1
study : 0.2
AI    : 0.6
hard  : 0.1
새로운 토큰 벡터는 각 Value Vector를 위 비율로 결합한 결과가 된다.
따라서 Self-Attention을 통과한 토큰 벡터에는 원래 단어 자체의 정보뿐 아니라 문장 속 다른 단어와의 관계도 포함된다.
Self-Attention 전체 계산
입력 토큰 벡터 X
        ↓
Q, K, V 생성
        ↓
QKᵀ로 관련성 계산
        ↓
√dₖ로 Scaling
        ↓
Softmax로 확률화
        ↓
V와 가중합
        ↓
문맥이 반영된 토큰 벡터
수식으로는 다음과 같이 정리된다.
Attention(Q, K, V)
= Softmax(QKᵀ / √dₖ)V
Multi-Head Attention: 여러 관점에서 문장을 본다
하나의 Attention만 사용하면 한 종류의 관계에 집중할 수 있다.
Multi-Head Attention은 Q, K, V를 여러 표현 공간으로 나누어 각각 Attention을 수행한다.
Head 1 → 문법적 관계
Head 2 → 의미적 유사성
Head 3 → 대명사와 대상의 관계
Head 4 → 문장 내 위치 관계
각 Head의 결과를 연결한 뒤 Linear Layer를 통해 하나의 통합 표현으로 만든다.
Head₁, Head₂, ..., Headₕ
→ Concatenate
→ Linear Transformation
Linear Layer는 흩어진 Head의 특징을 재조합하고, 다음 Layer가 사용하기 적절한 차원과 표현으로 변환한다.
Multi-Head Attention은 여러 관점에서 얻은 정보를 동시에 반영할 수 있게 한다.
Positional Encoding: 단어의 순서를 알려준다
Self-Attention은 모든 토큰을 동시에 비교한다.
따라서 Attention 구조만으로는 단어의 위치를 알 수 없다.
나는 밥을 먹었다.
밥이 나를 먹었다.
두 문장은 같은 단어를 포함하지만 순서에 따라 의미가 완전히 달라진다.
Transformer는 Token Embedding에 위치 정보를 더해 순서를 표현한다.
최종 입력 벡터
= Token Embedding + Positional Encoding
초기 Transformer에서는 Sin과 Cos 함수를 이용한 고정 Positional Encoding을 사용했다. 이후 모델에서는 학습형 Position Embedding이나 RoPE와 같은 다양한 방식이 사용된다.
Residual Connection과 Layer Normalization
Transformer의 각 Block에는 Add & Norm이 포함된다.
Residual Connection
Layer의 출력에 원래 입력을 더한다.
Output = Input + Attention(Input)이 방식은 원본 정보를 보존하고 깊은 네트워크에서 Gradient가 안정적으로 전달되도록 돕는다.
Layer Normalization
각 토큰 벡터의 평균과 분산을 정규화한다.
입력 분포가 지나치게 달라지는 것을 방지하여 학습을 빠르고 안정적으로 만든다.
Feed Forward Network
Attention은 토큰 사이의 관계를 섞는 역할을 한다.
그다음 각 토큰에는 동일한 Feed Forward Network가 독립적으로 적용된다.
FFN(x) = Activation(xW₁ + b₁)W₂ + b₂Feed Forward Network는 비선형성을 추가해 문맥 벡터를 더 복잡하고 풍부한 표현으로 변환한다.
정리하면 다음과 같다.
Attention
→ 토큰 간 정보 교환

Feed Forward Network
→ 각 토큰 표현의 비선형 변환
Masked Self-Attention: 미래 토큰을 보지 못하게 한다
GPT와 같은 생성 모델은 다음 토큰을 예측해야 한다.
학습 중 미래 단어를 미리 볼 수 있다면 정답을 그대로 참고하는 문제가 발생한다.
따라서 현재 위치보다 뒤에 있는 토큰의 Attention Score를 차단한다.
I              → study 예측
I study        → AI 예측
I study AI     → hard 예측
Attention Matrix에서 미래 위치에는 매우 작은 값이나 음의 무한대를 적용하고, Softmax 이후 가중치가 0이 되도록 만든다.
이를 Causal Mask 또는 Masked Self-Attention이라고 한다.
        I  study  AI  hard
I       O    X     X    X
study   O    O     X    X
AI      O    O     O    X
hard    O    O     O    O
이 구조 덕분에 모델은 현재까지 생성된 토큰만 이용해 다음 토큰을 예측한다.
BERT와 GPT의 구조 차이
Transformer를 어떻게 사용하느냐에 따라 모델의 성격이 달라진다.
| 모델 | 주요 구조정보 | 처리 방식 | 대표 작업 |
| BERT | Encoder 중심 | 양방향 문맥 이해 | 분류, 추출, 문장 이해 |
| GPT | Decoder 중심 | 이전 토큰만 보고 다음 토큰 생성 | 생성, 대화, 코드 작성 |
| T5 등 | Encoder–Decoder | 입력을 이해해 다른 시퀀스로 변환 | 번역, 요약, 변환 |
BERT는 문장 전체를 양방향으로 참고하는 데 강점이 있다.
GPT는 Causal Mask를 사용해 왼쪽에서 오른쪽으로 다음 토큰을 생성한다.
현대 LLM은 Decoder-only 구조를 기반으로 하면서도 대규모 사전학습과 Instruction Tuning을 통해 요약, 분류, 질의응답, 코딩 등 다양한 작업을 수행한다.
5. LLM을 실제 시스템에 활용하는 방법
좋은 모델은 무엇으로 판단할까?
모델을 선택할 때 단순히 하나의 순위만 확인해서는 안 된다.
LLM의 성능은 작업에 따라 다르기 때문이다.
대표적인 평가 영역은 다음과 같다.
| Reasoning | 논리적·과학적 추론 |
| Mathematics | 수학 문제 해결 |
| Coding | 코드 생성과 저장소 문제 해결 |
| Knowledge | 다양한 전문 분야 지식 |
| Truthfulness | 사실성과 환각 억제 |
| Multimodal | 이미지·음성·영상 이해 |
| Tool Use | 함수와 외부 도구 활용 |
| Long Context | 긴 문서와 대화 처리 |
| Safety | 유해 응답과 편향 통제 |
| Efficiency | 속도, 지연시간, API 비용 |
여기서는 Stanford HELM, Vellum, Hugging Face Open LLM Leaderboard 등 서로 다른 목적의 평가체계를 소개한다. HELM은 학술적으로 폭넓은 평가를 제공하고, 산업계 Leaderboard는 최신 모델의 추론·코딩·속도·가격 등을 비교하며, Open LLM Leaderboard는 공개 모델을 중심으로 평가한다.
벤치마크 1위가 항상 최적의 모델은 아니다
프로젝트에서 모델을 고를 때는 실제 업무 기준을 먼저 정의해야 한다.
예를 들어 사내 문서 요약 시스템이라면 수학 벤치마크보다 다음 항목이 중요할 수 있다.
- 한국어 요약 품질
- 긴 문서 처리 능력
- 근거 문장 유지 여부
- 개인정보 보호
- 요청당 비용
- 응답 속도
- 사내 배포 가능 여부
코딩 Agent라면 다음 기준이 더 중요하다.
- 저장소 단위 코드 이해
- Tool 사용 능력
- 테스트 실행과 오류 수정
- 긴 작업의 일관성
- 코드 보안과 라이선스
- 반복 호출 비용
따라서 공개 Leaderboard는 후보를 좁히는 참고자료이고, 최종 선택은 자체 평가 데이터셋으로 검증해야 한다.
업무 요구사항 정의
→ 후보 모델 선정
→ 자체 평가셋 구성
→ 품질·비용·속도 비교
→ 운영 환경에서 검증
Closed Model과 Open-weight Model
LLM은 제공 방식에 따라 크게 두 유형으로 나눌 수 있다.
API 기반 모델
외부 서비스의 API를 호출해 사용한다.
장점은 높은 성능과 쉬운 도입, 관리 부담이 적다는 것이다.
반면 API 비용, 외부 전송 보안, 서비스 종속성을 고려해야 한다.
Open-weight Model
모델의 Weight를 내려받아 직접 실행하거나 Fine-tuning할 수 있다.
다음과 같은 경우에 유리하다.
- 내부 데이터가 외부로 나가면 안 되는 경우
- 특정 도메인에 맞게 모델을 조정해야 하는 경우
- 오프라인 환경에서 실행해야 하는 경우
- 장기적으로 호출 비용을 통제해야 하는 경우
하지만 GPU 인프라와 모델 배포, 최적화, 모니터링에 대한 운영 역량이 필요하다.
LLM에서 AI Agent로
일반적인 LLM은 사용자의 입력을 받아 답변을 생성한다.
AI Agent는 여기에 목표, 도구, 메모리와 반복 작업 구조를 추가한다.
목표 확인
→ 작업 계획
→ 필요한 도구 선택
→ 도구 실행
→ 결과 관찰
→ 계획 수정
→ 최종 결과 생성
Agent는 다음 작업을 수행할 수 있다.
- 웹이나 문서 검색
- 데이터베이스 조회
- 코드 실행
- 파일 생성
- API 호출
- 결과 검증
- 다음 작업 결정
Multi-Agent 구조
하나의 Agent가 모든 작업을 맡는 대신 역할을 분리할 수도 있다.
블로그 글 작성 시스템을 예로 들면 다음과 같다.
| Planner | 주제와 독자 분석, 글의 구조 기획 |
| Researcher | 관련 자료와 근거 수집 |
| Writer | 기획과 자료를 바탕으로 초안 작성 |
| Reviewer | 사실, 논리와 누락 내용 검토 |
| Editor | 문체와 형식 최종 수정 |
Planner
→ Researcher
→ Writer
→ Reviewer
→ Editor
강의자료의 CrewAI 예시에서도 콘텐츠 기획자, 작성자, 편집자가 각각 역할과 목표를 부여받아 순차적으로 결과를 만드는 구조를 보여준다.
Multi-Agent를 사용하면 역할별 기준을 명확하게 분리할 수 있지만 Agent가 많아질수록 비용과 지연시간, 오류 전파 가능성도 증가한다.
따라서 단순한 작업에 무조건 Multi-Agent를 사용하는 것보다 작업의 복잡성에 맞는 구조를 선택해야 한다.
AI는 대체보다 증강의 관점으로 볼 수 있다
AI가 인간의 업무를 완전히 대체하는 접근과 함께 Augmented Intelligence, 즉 증강 지능의 관점을 소개한다.
증강 지능은 AI가 사람의 경험과 판단을 대신하는 것이 아니라 확장하는 방식이다.
사람
→ 문제 정의, 판단, 책임

AI
→ 검색, 생성, 반복 처리, 대안 분석
예를 들어 데이터 분석가는 AI를 통해 코드 초안을 만들고 이상 패턴 후보를 찾을 수 있지만, 분석 기준을 정하고 결과가 실제 업무에 적합한지 판단하는 일은 여전히 사람이 담당한다.
좋은 AI 시스템의 목표는 사람을 단순히 제거하는 것이 아니라, 사람이 더 높은 수준의 문제에 집중하도록 지원하는 데 있다.
전체 흐름 다시 보기
이번 주차의 개념은 다음과 같이 하나의 흐름으로 연결된다.
사람의 언어
→ 토큰과 숫자 벡터로 변환
→ 주변 문맥에서 의미 관계 학습
→ Language Model이 다음 토큰 예측
→ Attention으로 중요한 토큰 선택
→ Transformer로 전체 관계를 병렬 계산
→ 대규모 데이터로 사전학습
→ 다양한 작업을 수행하는 LLM
→ 도구와 메모리를 결합한 AI Agent
핵심 정리
Software의 변화
Software 1.0: 사람이 규칙을 코드로 작성
Software 2.0: 사람이 데이터를 제공하고 모델을 학습
Software 3.0: 사람이 목표와 Context를 정의하고 AI가 작업 수행
NLP 표현 방식의 변화
One-hot / BoW / TF-IDF
→ Word Embedding
→ Contextual Embedding
언어모델 구조의 변화
RNN
→ LSTM·GRU
→ Seq2Seq
→ Attention
→ Transformer
→ LLM
Transformer의 핵심
Query: 무엇을 찾는가?
Key: 어떤 정보가 있는가?
Value: 실제로 전달할 정보는 무엇인가?
Attention(Q, K, V)
= Softmax(QKᵀ / √dₖ)VLLM 활용의 변화
단순 질의응답
→ 프롬프트 기반 작업 수행
→ 외부 도구 활용
→ AI Agent
→ Multi-Agent 시스템
복습 질문
- Software 1.0, 2.0, 3.0의 가장 큰 차이는 무엇인가?
- One-hot Vector와 Word Embedding은 단어 관계를 어떻게 다르게 표현하는가?
- 분포가설에서 단어의 의미는 무엇으로 결정되는가?
- 고정 Word Embedding이 다의어를 처리하기 어려운 이유는 무엇인가?
- RNN이 긴 문장을 처리할 때 발생하는 장기 의존성 문제는 무엇인가?
- Seq2Seq에서 하나의 Context Vector만 사용하면 어떤 문제가 발생하는가?
- Self-Attention에서 Query, Key, Value는 각각 어떤 역할을 하는가?
- Attention Score를 √dₖ로 나누는 이유는 무엇인가?
- Multi-Head Attention이 하나의 Attention보다 유리한 이유는 무엇인가?
- GPT의 Masked Self-Attention은 미래 토큰을 왜 차단하는가?
- 공개 Leaderboard 1위 모델이 실제 프로젝트의 최적 모델이라고 단정할 수 없는 이유는 무엇인가?
- 단일 Agent와 Multi-Agent 구조는 각각 어떤 작업에 적합한가?
'개발 > SKALA 4기' 카테고리의 다른 글
| [SKALA] Spring Boot 설정 관리와 MVC·Actuator 정리 (0) | 2026.07.29 |
|---|---|
| [SKALA] 객체지향(OOP)과 Spring Boot 핵심 정리 (0) | 2026.07.27 |
| [SKALA] Prompt 설계 및 Context Engineering (1) | 2026.07.23 |
| [SKALA] 데이터 전처리와 상관·회귀분석 정리 (0) | 2026.07.23 |
| [SKALA] 데이터 분석 개요와 기초통계 정리 (0) | 2026.07.23 |