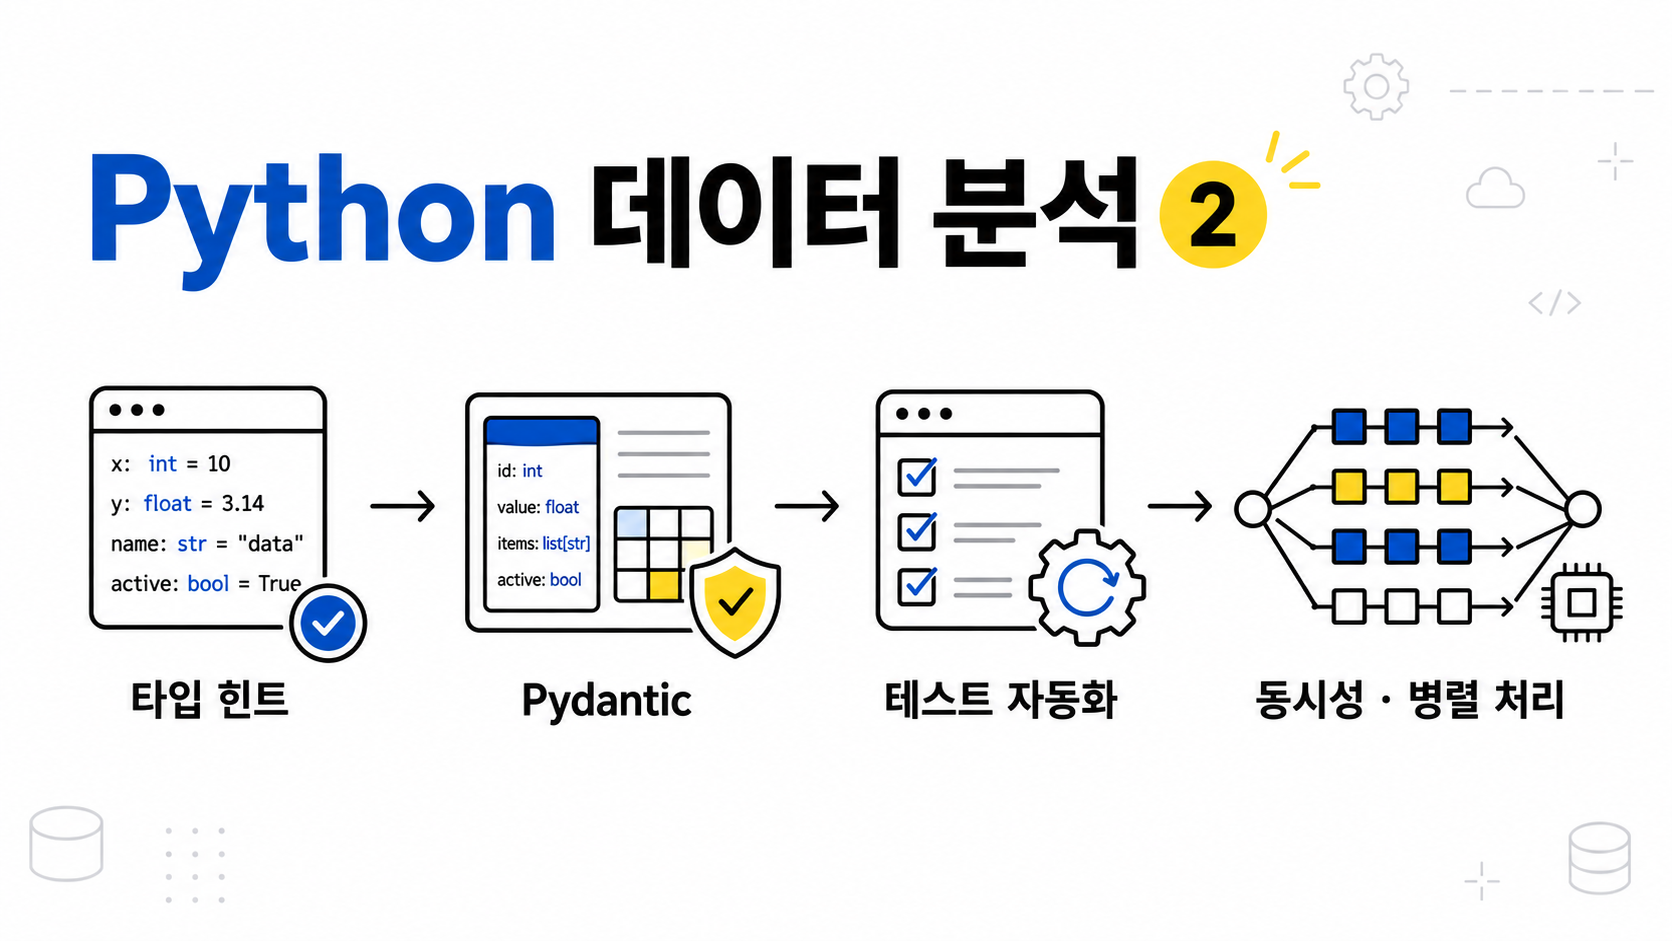
타입 힌트, Pydantic, 테스트 자동화와 동시성·병렬 처리
[SKALA] 5주차 학습 정리 ①: 데이터 분석 및 Python 기초
데이터 분석 코드를 안정적으로 작성하려면 문법만 아는 것보다 다음 내용을 함께 이해해야 한다.Python 코드가 실행되는 과정→ 데이터를 담을 자료구조 선택→ 반복 작업을 간결하게 표현→ 기
daniellee09.tistory.com
1편에서는 Python 코드가 실행되는 구조부터 자료구조, 컴프리헨션, 함수, 파일 처리와 예외 처리까지 정리했다.
이번에는 작성한 코드를 단순히 실행하는 수준에서 벗어나 다음 단계로 넘어가 본다.
타입 힌트로 함수의 입력과 출력 명시
→ Pydantic으로 실제 데이터 검증
→ pytest로 기능 테스트
→ Ruff와 pre-commit으로 코드 품질 관리
→ asyncio와 multiprocessing으로 처리 속도 개선
데이터 분석 코드도 규모가 커지면 여러 사람이 함께 사용하고 반복해서 실행하게 된다. 이때 중요한 것은 한 번 실행되는 코드가 아니라, 입력 데이터가 달라져도 안정적으로 동작하고 같은 환경에서 같은 결과를 재현할 수 있는 코드를 만드는 것이다.
1. 타입 힌트와 데이터 모델링
타입 힌트란?
Python은 변수의 자료형을 선언하지 않아도 실행할 수 있는 동적 타입 언어다.
def add(x, y):
    return x + y
이 함수는 숫자를 받을 수도 있고 문자열을 받을 수도 있다.
print(add(1, 2))          # 3
print(add("A", "B"))      # AB
자유롭게 사용할 수 있다는 장점이 있지만, 함수가 어떤 값을 받아야 하는지 코드만 보고 바로 판단하기 어렵다.
타입 힌트를 추가하면 매개변수와 반환값의 의도를 명확하게 표현할 수 있다.
def add(x: int, y: int) -> int:
    return x + y
x: int
→ x는 정수를 받을 예정

y: int
→ y는 정수를 받을 예정

-> int
→ 반환값도 정수일 예정
타입 힌트는 기본적으로 Python의 실행 방식을 바꾸지 않는다. 잘못된 타입을 전달해도 실행 자체가 자동으로 차단되는 것은 아니며, 에디터의 자동완성이나 mypy·Pylance 같은 정적 분석 도구가 오류를 찾아내는 데 사용된다.
기본 타입과 컬렉션 타입
name: str = "Alice"
age: int = 25
score: float = 95.5
is_active: bool = True
List와 Dictionary 내부의 타입도 표현할 수 있다.
names: list[str] = [
    "Alice",
    "Bob"
]

ages: dict[str, int] = {
    "Alice": 25,
    "Bob": 30
}
함수에서는 다음처럼 사용한다.
def compute_average(
    values: list[float]
) -> float:
    return sum(values) / len(values)
average = compute_average(
    [80.0, 90.0, 100.0]
)

print(average)
다른 사람이 함수를 사용할 때 values에 실수 목록을 전달해야 한다는 사실을 함수 이름과 타입만으로 파악할 수 있다.
Optional
값이 존재하지 않을 가능성이 있다면 Optional로 표현할 수 있다.
from typing import Optional


def find_user_name(
    user_id: int
) -> Optional[str]:
    if user_id == 1:
        return "Alice"

    return None
Optional[str]은 다음과 같은 의미다.
str 또는 None
내부적으로는 다음 표현과 같다.
str | None
from typing import Union

Optional[str]
Union[str, None]
str | None
모두 문자열이나 None이 올 수 있다는 뜻이다.
주의할 점은 Optional이 기본값을 자동으로 만들어 주는 기능은 아니라는 것이다.
def greet(
    name: Optional[str] = None
) -> str:
    if name:
        return f"Hello, {name}"

    return "Hello, anonymous"
Optional은 타입의 가능성을 표현할 뿐이며, 실제 None 처리는 함수 내부에서 작성해야 한다.
Union과 Literal
여러 타입 중 하나를 받을 수 있다면 Union을 사용한다.
from typing import Union


def normalize_id(
    value: Union[str, int]
) -> str:
    return str(value)
Python 3.10 이상에서는 |를 사용할 수 있다.
def normalize_id(
    value: str | int
) -> str:
    return str(value)
normalize_id("100")
normalize_id(100)
정해진 문자열만 허용하고 싶다면 Literal을 사용할 수 있다.
from typing import Literal


FillMethod = Literal[
    "mean",
    "median",
    "drop"
]


def fill_missing(
    method: FillMethod
) -> None:
    print(
        f"결측치 처리 방식: {method}"
    )
fill_missing("mean")   # 허용
fill_missing("drop")   # 허용
fill_missing("zero")   # 정적 검사 오류
Literal은 설정값이나 처리 방식처럼 선택 가능한 값이 명확하게 제한되어 있을 때 유용하다.
Any는 최소한으로 사용한다
from typing import Any


def log_data(data: Any) -> None:
    print(data)
Any는 모든 타입을 허용한다.
log_data("hello")
log_data(100)
log_data([1, 2, 3])
log_data(None)
편리해 보이지만 타입 검사를 사실상 포기하는 것과 같다.
IDE 자동완성 약화
정적 타입 오류 탐지 불가
잘못된 값이 함수 내부까지 전달
데이터 구조를 알 수 없는 외부 라이브러리 경계 등 꼭 필요한 상황이 아니라면 구체적인 타입을 작성하는 것이 좋다.
Callable로 함수의 타입 표현하기
Python에서는 함수도 다른 함수의 인자로 전달할 수 있다.
from typing import Callable


def apply_operation(
    x: int,
    y: int,
    operation: Callable[
        [int, int],
        int
    ]
) -> int:
    return operation(x, y)
result = apply_operation(
    3,
    4,
    lambda a, b: a + b
)

print(result)  # 7
Callable[[int, int], int]의 의미는 다음과 같다.
정수 두 개를 받고
→ 정수 하나를 반환하는 함수
정렬 기준, 데이터 변환 함수와 전처리 함수를 매개변수로 받을 때 유용하다.
Generic과 Protocol
Generic은 자료형만 다르고 동작은 같은 구조를 재사용할 때 사용한다.
from typing import Generic, TypeVar


T = TypeVar("T")


class Stack(Generic[T]):

    def __init__(self) -> None:
        self._items: list[T] = []

    def push(self, item: T) -> None:
        self._items.append(item)

    def pop(self) -> T:
        return self._items.pop()
number_stack = Stack[int]()
number_stack.push(10)

text_stack = Stack[str]()
text_stack.push("Python")
하나의 Stack 구현을 정수용, 문자열용 등으로 재사용하면서 타입 안정성을 유지할 수 있다.
Protocol은 특정 클래스를 상속했는지가 아니라, 필요한 메서드를 가지고 있는지를 기준으로 타입을 검사한다.
from typing import Protocol


class Writable(Protocol):

    def write(
        self,
        text: str
    ) -> None:
        ...


def save_message(
    target: Writable
) -> None:
    target.write("Hello")
write() 메서드를 가진 객체라면 별도의 상속 관계가 없어도 Writable 규약을 만족하는 것으로 볼 수 있다.
Pydantic으로 실제 데이터 검증하기
타입 힌트는 코드의 의도를 표현하지만 런타임 데이터를 자동으로 검증하지 않는다.
외부 API나 CSV에서 들어온 데이터를 실제로 검사하려면 Pydantic을 사용할 수 있다.
from typing import Optional

from pydantic import BaseModel, Field


class SalesRecord(BaseModel):

    month: str

    region: str

    amount: float = Field(
        gt=0,
        description="0보다 큰 매출"
    )

    category: Optional[str] = None
정상 데이터는 객체로 변환된다.
record = SalesRecord(
    month="2026-08",
    region="서울",
    amount=1500,
    category="전자"
)

print(record.amount)
Dictionary를 검증할 수도 있다.
raw_data = {
    "month": "2026-08",
    "region": "서울",
    "amount": 1500
}

record = SalesRecord.model_validate(
    raw_data
)
검증을 통과한 객체는 다시 Dictionary로 변환할 수 있다.
result = record.model_dump()

print(result)
잘못된 값이 들어오면 어느 필드에서 어떤 규칙이 실패했는지 확인할 수 있다.
from pydantic import ValidationError


try:
    SalesRecord(
        month="2026-08",
        region="서울",
        amount=-100
    )

except ValidationError as error:
    print(error)
Pydantic의 BaseModel은 스키마 정의와 데이터 검증을 함께 수행하며, model_validate()와 model_dump()를 통해 Dictionary와 모델 사이를 변환할 수 있다.
유효한 데이터와 오류 데이터 분리하기
CSV의 일부 행만 잘못되었다고 해서 전체 처리를 중단할 필요는 없다.
import csv

from pydantic import ValidationError


valid_records: list[SalesRecord] = []
error_records: list[dict] = []


with open(
    "sales.csv",
    encoding="utf-8"
) as file:
    reader = csv.DictReader(file)

    for row_number, row in enumerate(
        reader,
        start=2
    ):
        try:
            record = (
                SalesRecord.model_validate(row)
            )

            valid_records.append(record)

        except ValidationError as error:
            error_records.append({
                "row": row_number,
                "error": str(error)
            })
print(
    f"정상: {len(valid_records)}건"
)

print(
    f"오류: {len(error_records)}건"
)
이 구조를 사용하면 정상 데이터는 분석에 사용하고, 잘못된 데이터는 별도의 오류 파일로 남길 수 있다.
mypy로 실행 전에 타입 검사하기
다음 코드는 Python에서 실제로 실행될 수 있지만 작성한 타입 의도와 맞지 않는다.
def compute_average(
    values: list[float]
) -> float:
    return sum(values) / len(values)


compute_average(
    ["A", "B", "C"]
)
mypy를 실행하면 타입이 맞지 않는 부분을 찾을 수 있다.
mypy analysis.py
Argument 1 has incompatible type
"list[str]"; expected "list[float]"
프로젝트 전체를 검사할 수도 있다.
mypy src/
타입 검사를 엄격하게 적용하려면 설정 파일을 사용할 수 있다.
[mypy]
python_version = 3.11
strict = True
disallow_untyped_defs = True
ignore_missing_imports = True
disallow_untyped_defs를 활성화하면 타입이 없는 함수 정의를 검사할 수 있다.
2. 테스트와 코드 품질 자동화
디버깅은 오류 위치를 찾는 과정이다
문제가 발생했을 때 무조건 print()를 추가하는 방법만 사용할 필요는 없다.
예외의 전체 호출 흐름은 traceback으로 확인할 수 있다.
import traceback


try:
    result = 10 / 0

except Exception as error:
    print(
        "에러 발생:",
        error
    )

    traceback.print_exc()
간단한 조건 검증에는 assert를 사용할 수 있다.
def divide(
    a: float,
    b: float
) -> float:
    assert b != 0, (
        "b는 0이 될 수 없습니다."
    )

    return a / b
다만 사용자 입력이나 비즈니스 오류처럼 실제 서비스에서 반드시 처리해야 하는 조건은 assert보다 명시적인 예외를 사용하는 것이 적절하다.
VS Code에서는 중단점을 설정하여 특정 줄에서 실행을 멈출 수 있다.
중단점 설정
→ 프로그램 실행
→ 해당 줄에서 정지
→ 변수와 객체 상태 확인
→ 한 줄씩 다음 코드 실행
DataFrame의 컬럼, 데이터 타입과 결측치 상태를 확인할 때 여러 print()를 작성하는 것보다 디버거가 편리할 수 있다.
프로젝트 구조 나누기
코드와 테스트를 분리하면 프로젝트의 역할이 명확해진다.
my_project/
├── src/
│   └── sales/
│       ├── __init__.py
│       └── summary.py
│
├── tests/
│   └── test_summary.py
│
├── pyproject.toml
├── requirements.txt
└── README.md
src
→ 실제 기능 코드

tests
→ 기능을 확인하는 테스트 코드

pyproject.toml
→ 도구 설정

requirements.txt
→ 패키지와 버전
pytest의 기본 구조
다음 함수를 테스트한다고 가정해 보자.
# src/sales/summary.py

def add(
    a: int,
    b: int
) -> int:
    return a + b
테스트 파일은 test_로 시작하도록 작성한다.
# tests/test_summary.py

from src.sales.summary import add


def test_add() -> None:
    assert add(1, 2) == 3
프로젝트 루트에서 다음 명령어를 실행한다.
pytest
pytest는 기본적으로 다음 규칙을 사용해 테스트를 찾는다.
파일
→ test_*.py 또는 *_test.py

함수
→ test_*로 시작

탐색
→ 실행 위치 아래의 하위 디렉터리까지 검색
특정 파일이나 함수만 실행할 수도 있다.
pytest tests/test_summary.py
pytest \
  tests/test_summary.py::test_add
Fixture
여러 테스트에서 같은 데이터를 사용한다면 Fixture로 분리할 수 있다.
import pandas as pd
import pytest


@pytest.fixture
def sample_frame():
    return pd.DataFrame({
        "amount": [
            1000,
            None,
            3000
        ],
        "region": [
            "서울",
            "부산",
            None
        ]
    })
def test_row_count(
    sample_frame
) -> None:
    assert len(sample_frame) == 3
Fixture는 테스트용 데이터나 공통 설정을 반복해서 만드는 코드를 줄여 준다.
Parametrize
같은 함수를 여러 입력값으로 검사할 때는 parametrize를 사용할 수 있다.
import pytest


@pytest.mark.parametrize(
    "value, expected",
    [
        (1000, True),
        (1, True),
        (0, False),
        (-100, False)
    ]
)
def test_positive_amount(
    value,
    expected
):
    result = value > 0

    assert result is expected
하나의 테스트 함수로 여러 경계값을 검사할 수 있다.
pytest.ini
pytest의 기본 옵션을 프로젝트에 저장할 수 있다.
[pytest]
minversion = 6.0
addopts = -ra -q --tb=short
testpaths = tests
python_files = test_*.py *_test.py
python_classes = Test*
python_functions = test_*
testpaths
→ 테스트를 찾을 기본 디렉터리

python_files
→ 테스트 파일명 규칙

python_functions
→ 테스트 함수명 규칙

addopts
→ pytest 실행 시 기본으로 적용할 옵션
설정 파일은 일반적으로 프로젝트 루트에 두며 pytest 실행 시 자동으로 적용된다.
테스트 커버리지
테스트가 성공하더라도 모든 코드가 실제로 실행되었다는 뜻은 아니다.
pytest-cov를 사용하면 테스트되지 않은 코드 위치를 확인할 수 있다.
pip install pytest-cov
pytest tests/ \
  --cov=src \
  --cov-report=term-missing
결과는 다음과 비슷하게 표시된다.
Name              Stmts   Miss   Cover
src/clean.py         25      3     88%
src/features.py      38      0    100%
커버리지 수치만 높이는 것이 목적은 아니지만, 중요한 예외 경로나 조건문이 테스트에서 빠졌는지를 확인하는 지표로 사용할 수 있다.
Ruff로 코드 검사와 포매팅하기
Ruff는 Python 코드의 문제를 검사하고 일부 오류를 자동으로 수정할 수 있다.
pip install ruff
린팅 검사:
ruff check .
자동 수정:
ruff check --fix .
포매팅:
ruff format .
pyproject.toml에서 규칙을 관리할 수 있다.
[tool.ruff]
line-length = 88
select = ["E", "F", "I", "UP"]
ignore = ["E501"]

[tool.ruff.format]
quote-style = "double"
indent-style = "space"
E
→ 코드 스타일 오류

F
→ 논리적 오류와 사용하지 않는 변수 등

I
→ import 정렬

UP
→ 최신 Python 문법으로 개선
Ruff는 린팅, Import 정리와 포매팅을 하나의 도구 흐름으로 구성할 수 있다.
pre-commit으로 커밋 전 검사하기
코드를 Git에 올린 뒤 오류를 발견하기보다, 커밋 전에 자동 검사하도록 만들 수 있다.
pip install pre-commit
pre-commit install
.pre-commit-config.yaml을 작성한다.
repos:
  - repo: https://github.com/astral-sh/ruff-pre-commit
    rev: v0.6.0
    hooks:
      - id: ruff
        args:
          - --fix

      - id: ruff-format

  - repo: https://github.com/pre-commit/mirrors-mypy
    rev: v1.8.0
    hooks:
      - id: mypy
전체 파일을 검사할 수도 있다.
pre-commit run --all-files
검사를 통과하지 못하면 커밋이 중단된다.
git commit
→ Ruff 검사
→ 타입 검사
→ 오류 발견
→ 커밋 중단
→ 코드 수정 후 재시도
pre-commit은 포매팅, 린팅, 타입 검사와 디버깅 코드 확인을 Git 단계에서 자동화할 수 있다.
requirements.txt와 재현 가능한 환경
현재 환경에 설치된 패키지를 파일로 저장한다.
pip freeze > requirements.txt
다른 환경에서는 같은 버전을 다시 설치할 수 있다.
pip install -r requirements.txt
.gitignore에는 다음 항목을 포함할 수 있다.
.venv/
.env
__pycache__/
*.pyc
.coverage
분석 결과를 신뢰하려면 코드뿐 아니라 실행한 패키지 버전과 테스트 조건도 함께 관리해야 한다.
GitHub Actions로 자동 검사하기
로컬 검사를 통과했더라도 다른 환경에서 다시 확인하는 것이 안전하다.
name: CI

on:
  - push
  - pull_request

jobs:
  quality-check:
    runs-on: ubuntu-latest

    steps:
      - uses: actions/checkout@v3

      - uses: actions/setup-python@v4
        with:
          python-version: "3.11"

      - run: |
          python -m pip install --upgrade pip
          pip install -r requirements.txt

      - run: ruff check .

      - run: mypy src/

      - run: pytest
전체 흐름은 다음과 같다.
코드 작성
→ Ruff와 mypy 실행
→ pytest 실행
→ Git 커밋
→ GitHub Push
→ GitHub Actions에서 다시 검사
3. 비동기와 병렬 처리
동시성과 병렬성
동시성과 병렬성은 비슷해 보이지만 목적이 다르다.
| 구분 | 동시성 | 병렬성 |
| 영어 | Concurrency | Parallelism |
| 실행 방식 | 대기 중 다른 작업 진행 | 여러 작업을 실제로 동시에 실행 |
| 적합한 작업 | I/O Bound | CPU Bound |
| 대표 도구 | asyncio, httpx, Thread | multiprocessing |
| 예시 | API 호출, 파일·DB 대기 | 수치 계산, 이미지 처리 |
I/O Bound
→ 계산보다 네트워크나 파일 응답을 기다리는 시간이 큼

CPU Bound
→ 계산 자체가 오래 걸림
API 요청이나 파일 읽기처럼 대기 시간이 긴 작업에는 동시성이 적합하고, 대용량 계산이나 이미지 변환처럼 CPU를 계속 사용하는 작업에는 병렬 처리가 적합하다.
Threading과 GIL
CPython에는 GIL이라는 실행 제약이 있다.
GIL
→ 한 시점에 하나의 Thread만
  Python Bytecode를 실행하도록 제한
따라서 순수 Python으로 CPU 연산을 수행하는 작업은 Thread를 늘려도 여러 CPU Core를 충분히 활용하지 못할 수 있다.
import threading


def cpu_task():
    return sum(
        range(10_000_000)
    )


threads = [
    threading.Thread(
        target=cpu_task
    )
    for _ in range(4)
]
Thread를 네 개 만들었더라도 CPU Bound Python 코드가 네 Core에서 완전히 병렬 실행되는 것은 아니다.
반면 네트워크나 파일 응답을 기다리는 I/O 작업에서는 대기 중 다른 Thread가 실행될 수 있다.
import threading
import time


def io_task(name: str):
    print(
        f"{name} 시작"
    )

    time.sleep(1)

    print(
        f"{name} 종료"
    )
NumPy처럼 내부 연산을 C나 BLAS 라이브러리에서 수행하는 경우에는 Python Bytecode 실행과 다른 방식으로 병렬 연산이 수행될 수 있다.
Multiprocessing
CPU 연산을 실제 여러 Core에서 실행하려면 별도의 Process를 사용할 수 있다.
from multiprocessing import Pool


def square(
    number: int
) -> int:
    return number ** 2


if __name__ == "__main__":

    with Pool(processes=4) as pool:
        results = pool.map(
            square,
            [1, 2, 3, 4]
        )

    print(results)
각 Process는 별도의 메모리 공간과 Python Interpreter를 사용하므로 GIL의 영향을 우회할 수 있다.
Process 사이에서 데이터를 전달해야 한다면 Queue 등을 사용할 수 있다.
from multiprocessing import (
    Process,
    Queue
)


def worker(queue: Queue):
    queue.put(
        "작업 완료"
    )


if __name__ == "__main__":

    queue = Queue()

    process = Process(
        target=worker,
        args=(queue,)
    )

    process.start()

    print(queue.get())

    process.join()
Process 사이의 데이터 복사와 전달에도 비용이 발생하기 때문에 작은 작업을 지나치게 많이 나누면 오히려 느려질 수 있다.
ProcessPoolExecutor
concurrent.futures를 이용하면 Process Pool을 비교적 간단하게 구성할 수 있다.
from concurrent.futures import (
    ProcessPoolExecutor
)

import multiprocessing as mp


def transform_chunk(
    chunk: list[int]
) -> list[int]:
    return [
        value ** 2
        for value in chunk
    ]
if __name__ == "__main__":

    data = list(
        range(100_000)
    )

    worker_count = mp.cpu_count()

    chunks = [
        data[index::worker_count]
        for index in range(worker_count)
    ]

    with ProcessPoolExecutor(
        max_workers=worker_count
    ) as executor:

        results = list(
            executor.map(
                transform_chunk,
                chunks
            )
        )
대용량 파일이나 데이터를 여러 Chunk로 나누어 전처리할 때 사용할 수 있다. 다만 프로세스 간 데이터 전달 비용까지 고려해서 Chunk 크기를 결정해야 한다.
asyncio의 기본 구조
비동기 함수는 async def로 정의한다.
import asyncio


async def work(
    name: str,
    seconds: int
) -> str:
    print(
        f"{name} 시작"
    )

    await asyncio.sleep(seconds)

    print(
        f"{name} 완료"
    )

    return name
여러 작업은 asyncio.gather()로 함께 실행할 수 있다.
async def main():

    results = await asyncio.gather(
        work("A", 2),
        work("B", 1),
        work("C", 3)
    )

    print(results)


asyncio.run(main())
A 시작
B 시작
C 시작
→ 각 작업이 대기하는 동안 다른 작업 진행
→ 먼저 끝난 작업부터 완료
하나의 Thread에서 실행되지만, 대기 중인 시간을 활용하여 여러 작업을 함께 진행한다.
httpx를 이용한 비동기 API 호출
import asyncio

import httpx


async def fetch(
    client: httpx.AsyncClient,
    url: str
) -> dict:
    try:
        response = await client.get(
            url,
            timeout=10
        )

        return response.json()

    except Exception as error:
        return {
            "error": str(error)
        }
async def fetch_all(
    urls: list[str]
) -> list:
    async with httpx.AsyncClient() as client:

        tasks = [
            fetch(client, url)
            for url in urls
        ]

        return await asyncio.gather(
            *tasks,
            return_exceptions=True
        )
urls = [
    "https://api.example.com/data/1",
    "https://api.example.com/data/2",
    "https://api.example.com/data/3"
]

results = asyncio.run(
    fetch_all(urls)
)
return_exceptions=True를 사용하면 일부 요청이 실패해도 다른 요청 결과까지 함께 받을 수 있다.
순차 호출
→ 요청 1 완료 후 요청 2 시작

비동기 호출
→ 요청 1을 기다리는 동안 요청 2와 3 시작
많은 API를 수집할 때 네트워크 대기 시간을 크게 줄일 수 있다.
먼저 측정하고 최적화하기
코드가 느리다는 느낌만으로 병렬 처리를 적용하면 오히려 복잡성만 증가할 수 있다.
간단한 코드 조각의 실행 시간은 timeit으로 측정한다.
import timeit


elapsed = timeit.timeit(
    "''.join(values)",
    setup=(
        "values = ['a'] * 1000"
    ),
    number=10_000
)

print(elapsed)
전체 함수의 호출 횟수와 누적 시간은 cProfile로 확인한다.
import cProfile


cProfile.run(
    "heavy_analysis(data)",
    sort="cumtime"
)
객체의 기본 메모리 크기는 sys.getsizeof()로 확인할 수 있다.
import sys


values = list(
    range(10_000)
)

generator = (
    value
    for value in range(10_000)
)

print(
    sys.getsizeof(values)
)

print(
    sys.getsizeof(generator)
)
성능 개선 순서

측정
→ 병목 함수 확인
→ 적절한 방법 선택
→ 변경 후 다시 측정
timeit, cProfile과 메모리 측정 도구를 통해 느린 지점을 확인한 뒤 비동기나 병렬 처리를 적용하는 것이 좋다.
4. 데이터 수집·검증 파이프라인 예제
앞에서 정리한 개념을 하나의 작은 파이프라인으로 연결해 보자.
여러 API 비동기 호출
→ 응답 수집
→ Pydantic 검증
→ 정상·오류 데이터 분리
→ CSV와 Parquet 저장
→ pytest 테스트
→ Ruff 검사
데이터 모델
from typing import Optional

from pydantic import BaseModel, Field


class ApiRecord(BaseModel):

    source: str

    value: float = Field(
        ge=0
    )

    description: Optional[str] = None
비동기 수집
실제 API마다 JSON 구조가 다르므로, 각 API 응답을 동일한 내부 구조로 바꾸는 정규화 과정이 필요하다.
import asyncio

import httpx


API_URLS = {
    "weather": (
        "https://api.example.com/weather"
    ),
    "country": (
        "https://api.example.com/country"
    ),
    "location": (
        "https://api.example.com/location"
    )
}
async def fetch_one(
    client: httpx.AsyncClient,
    name: str,
    url: str
) -> dict:
    try:
        response = await client.get(
            url,
            timeout=10
        )

        response.raise_for_status()

        return {
            "source": name,
            "data": response.json()
        }

    except Exception as error:
        return {
            "source": name,
            "error": str(error)
        }
async def collect_all() -> list[dict]:

    async with httpx.AsyncClient() as client:

        tasks = [
            fetch_one(
                client,
                name,
                url
            )
            for name, url
            in API_URLS.items()
        ]

        return await asyncio.gather(
            *tasks
        )
데이터 정규화와 검증
from pydantic import ValidationError


def normalize_response(
    result: dict
) -> dict:
    if "error" in result:
        raise ValueError(
            result["error"]
        )

    raw_data = result["data"]

    return {
        "source": result["source"],
        "value": raw_data["value"],
        "description": (
            raw_data.get("description")
        )
    }
def validate_results(
    results: list[dict]
) -> tuple[
    list[ApiRecord],
    list[dict]
]:
    valid: list[ApiRecord] = []
    errors: list[dict] = []

    for result in results:
        try:
            normalized = (
                normalize_response(result)
            )

            record = (
                ApiRecord.model_validate(
                    normalized
                )
            )

            valid.append(record)

        except (
            ValueError,
            KeyError,
            ValidationError
        ) as error:

            errors.append({
                "source": result.get(
                    "source",
                    "unknown"
                ),
                "error": str(error)
            })

    return valid, errors
결과 저장
import json
from pathlib import Path

import pandas as pd


def save_results(
    valid: list[ApiRecord],
    errors: list[dict]
) -> None:
    output_dir = Path("output")
    output_dir.mkdir(
        exist_ok=True
    )

    rows = [
        record.model_dump()
        for record in valid
    ]

    frame = pd.DataFrame(rows)

    frame.to_csv(
        output_dir / "valid.csv",
        index=False
    )

    frame.to_parquet(
        output_dir / "valid.parquet",
        index=False
    )

    error_path = (
        output_dir / "errors.json"
    )

    error_path.write_text(
        json.dumps(
            errors,
            ensure_ascii=False,
            indent=2
        ),
        encoding="utf-8"
    )
전체 실행
def main() -> None:

    results = asyncio.run(
        collect_all()
    )

    valid, errors = (
        validate_results(results)
    )

    save_results(
        valid,
        errors
    )

    print(
        f"정상 데이터: {len(valid)}건"
    )

    print(
        f"오류 데이터: {len(errors)}건"
    )


if __name__ == "__main__":
    main()
간단한 테스트
import pytest
from pydantic import ValidationError


def test_valid_record() -> None:

    record = ApiRecord(
        source="weather",
        value=25.5
    )

    assert record.value == 25.5
def test_negative_value() -> None:

    with pytest.raises(
        ValidationError
    ):
        ApiRecord(
            source="weather",
            value=-1
        )
pytest tests/ -v
ruff check .
ruff format --check .
이 예제는 비동기 수집, Pydantic 스키마 검증, CSV·Parquet 저장, pytest 테스트와 Ruff 검사를 하나의 흐름으로 연결한 것이다.
전체 흐름 다시 보기
타입 힌트
→ 함수와 데이터 구조의 의도 표현

mypy·Pylance
→ 실행 전 타입 오류 탐지

Pydantic
→ 실행 중 실제 데이터 검증

pytest
→ 기능이 예상대로 동작하는지 확인

Coverage
→ 테스트되지 않은 코드 확인

Ruff
→ 코드 오류와 스타일 검사

pre-commit
→ 커밋 전 품질 검사 자동화

requirements.txt
→ 실행 환경 재현

asyncio
→ I/O 대기 시간 활용

multiprocessing
→ CPU Core를 이용한 병렬 계산

cProfile
→ 실제 성능 병목 확인
핵심 정리
타입 힌트
코드의 입력과 출력 규약
→ 가독성
→ 자동완성
→ 정적 오류 검사
Pydantic
외부 데이터
→ 스키마 변환
→ 타입·범위 검증
→ 정상 데이터와 오류 데이터 분리
테스트
pytest
→ 함수 단위 동작 검증

pytest-cov
→ 테스트되지 않은 경로 확인
코드 품질
Ruff
→ 린팅과 포매팅

pre-commit
→ 커밋 전 자동 검사

GitHub Actions
→ Push 이후 다시 검사
처리 방식 선택
API·파일·DB 대기
→ asyncio 또는 Threading

대용량 계산·전처리
→ Multiprocessing

최적화 전
→ timeit·cProfile로 측정
좋은 데이터 분석 코드는 결과만 한 번 출력하는 코드가 아니다.
입력 데이터가 잘못되었을 때 원인을 설명할 수 있고, 다른 환경에서도 다시 실행할 수 있으며, 변경 이후에도 같은 기능이 유지되는지 자동으로 확인할 수 있어야 한다.
타입 힌트와 검증은 데이터의 신뢰성을 높이고, 테스트와 코드 품질 도구는 변경의 안정성을 높인다. 여기에 작업 특성에 맞는 비동기·병렬 처리를 적용하면 단순한 분석 스크립트를 반복 실행 가능한 데이터 파이프라인으로 발전시킬 수 있다.
복습 질문
- 타입 힌트가 Python 런타임에 직접 영향을 주지 않는다는 것은 어떤 의미인가?
- Optional[str]과 str | None은 어떤 관계인가?
- Union, Literal과 Any는 각각 어떤 상황에 사용하는가?
- Callable은 어떤 함수의 타입을 표현할 때 사용하는가?
- Pydantic의 model_validate()와 model_dump()는 각각 어떤 역할을 하는가?
- Pydantic과 mypy의 검증 시점은 어떻게 다른가?
- pytest가 자동으로 인식하는 파일명과 함수명 규칙은 무엇인가?
- Fixture를 사용하면 어떤 반복을 줄일 수 있는가?
- 테스트 커버리지가 100%라고 해서 오류가 전혀 없다고 할 수 있는가?
- Ruff와 pre-commit은 어떤 방식으로 함께 사용할 수 있는가?
- 동시성과 병렬성은 어떤 차이가 있는가?
- CPU Bound 작업에서 Threading의 효과가 제한되는 이유는 무엇인가?
- Multiprocessing 사용 시 데이터 전달 비용을 고려해야 하는 이유는 무엇인가?
- asyncio.gather()는 여러 API 요청을 어떻게 처리하는가?
- 코드가 느릴 때 바로 병렬 처리하기보다 먼저 Profiling해야 하는 이유는 무엇인가?