분석 Framework부터 결측치와 이상치 처리까지
Feature Engineering은 단순히 모델에 넣을 컬럼을 추가하는 작업이 아니다.
분석 목적을 이해하고 데이터를 탐색한 뒤, 모델이 데이터의 의미를 더 잘 학습할 수 있도록 변수를 선택하고 정제하고 변환하는 전체 과정에 가깝다.
이번 학습 내용은 크게 다음 흐름으로 이어진다.
비즈니스 문제 이해
→ 데이터 탐색
→ 문제점 발견
→ 결측치와 이상치 처리
→ Feature Engineering 방향 결정
→ 모델링
전체 과정은 Intro, EDA, 기본·고급 전처리와 새로운 Feature 생성으로 구성되어 있다. 이번 글에서는 EDA와 기본 전처리 중 결측치·이상치까지 정리한다.
1. 분석은 모델이 아니라 문제 정의에서 시작한다
데이터 분석을 시작하면 가장 먼저 알고리즘이나 모델부터 선택하기 쉽다.
하지만 실제 분석에서는 모델을 선택하기 전에 다음 내용을 먼저 정의해야 한다.
어떤 문제를 해결하려는가?
→ 어떤 결과를 만들어야 하는가?
→ 결과를 누가 어떻게 사용할 것인가?
→ 그 결과를 만들기 위해 어떤 데이터가 필요한가?
분석 방법론은 일반적으로 다음 단계로 구성된다.
비즈니스 이해
→ 가설 수립과 데이터 이해
→ 데이터 준비
→ 분석 모델 정의
→ 모델 평가
→ 시스템 적용
각 단계는 독립적인 것이 아니라 앞뒤 단계가 계속 연결된다.
예를 들어 모델 성능이 좋지 않다면 단순히 알고리즘을 바꾸는 것이 아니라 다음 항목을 다시 확인할 수 있다.
분석 목표가 정확했는가?
데이터에 필요한 정보가 포함되어 있는가?
결측치와 이상치는 적절하게 처리되었는가?
변수가 문제를 충분히 표현하고 있는가?
평가 지표가 실제 업무 목적과 맞는가?
분석 Framework는 작업 순서뿐 아니라 각 단계의 활동, 방법, 도구와 산출물을 체계화한 가이드라인이다.
비즈니스 이해
분석의 첫 단계에서는 무엇을 예측할지보다 왜 예측해야 하는지를 이해해야 한다.
예를 들어 고객 이탈을 예측한다고 해보자.
단순한 분석 목표
→ 이탈 고객을 예측한다.

비즈니스 목표
→ 이탈 가능성이 높은 고객을 미리 발견하고
  유지 전략을 적용해 이탈률을 낮춘다.
같은 예측 모델이라도 결과가 실제 업무에 어떻게 활용되는지에 따라 중요한 평가 기준이 달라진다.
이탈 고객을 놓치지 않는 것이 중요하다면 단순 정확도보다 재현율이 더 중요할 수 있다.
데이터 이해
분석 목표를 정했다면 필요한 데이터를 확인한다.
어떤 데이터 항목이 필요한가?
현재 데이터는 어디에서 수집되는가?
데이터의 양과 품질은 충분한가?
외부에서 추가로 가져와야 할 데이터는 없는가?
고객 이탈을 분석한다면 다음과 같은 데이터가 후보가 될 수 있다.
최근 로그인 일자
서비스 이용 횟수
구매 횟수
고객 문의 횟수
가입 기간
최근 결제금액
요금제
단순히 사용할 수 있는 데이터를 모두 넣는 것이 아니라, 분석 목적과 실제 업무 흐름을 기준으로 필요한 데이터를 선정해야 한다.
데이터 준비와 Feature Engineering
데이터 준비 단계에서는 다음 작업이 수행된다.
데이터 구조 확인
→ 결측치 처리
→ 이상치 처리
→ 타입 변환
→ Scaling
→ Encoding
→ 중요한 변수 선택
→ 새로운 변수 생성
이 과정에서 업무 전문가의 지식도 중요하다.
예를 들어 최종 로그인 날짜만으로는 고객의 활동성을 직접 표현하기 어렵다. 현재 날짜와의 차이를 계산해 최근 로그인 후 경과일로 바꾸면 모델이 더 쉽게 활용할 수 있다.
최종 로그인 날짜
→ 최근 로그인 후 경과일
모델 평가와 시스템 적용
모델 성능이 높다고 해서 실제로 활용할 수 있는 것은 아니다.
예측 결과를 어떤 기준으로 업무에 적용할 것인가?
과도한 이상탐지는 어떻게 줄일 것인가?
운영 시스템과 어떤 방식으로 연결할 것인가?
배포 이후 성능은 어떻게 확인할 것인가?
데이터 변화로 성능이 낮아지면 언제 다시 학습할 것인가?
모델 평가는 기술적인 점수만 확인하는 것이 아니라 실제 비즈니스 효과까지 판단하는 과정이다.
배포 이후에는 데이터 분포와 모델 성능의 변화를 모니터링하고, 필요한 경우 정기적으로 모델을 업데이트해야 한다.
2. Feature Engineering이란?
Feature는 모델이 학습할 때 사용하는 입력 변수다.
고객 데이터

나이
지역
구매금액
구매횟수
최근 접속일
Feature Engineering은 원본 데이터를 모델이 문제를 더 잘 학습할 수 있는 의미 있는 Feature로 바꾸는 과정이다.
Raw Data
→ 데이터 정제
→ 의미 있는 Feature 생성
→ 모델 학습
→ 예측
데이터 품질이 나쁘면 좋은 모델을 만들기 어렵다.
하지만 데이터가 깨끗하다는 것만으로 충분한 것도 아니다.
나쁜 데이터
→ 나쁜 예측

깨끗하지만 정보가 부족한 데이터
→ 제한적인 예측

의미 있는 Feature가 포함된 데이터
→ 더 나은 예측
Feature Engineering의 핵심은 데이터를 단순히 정리하는 것이 아니라, 원본 데이터가 가진 정보를 모델이 이해하기 좋은 형태로 표현하는 데 있다.
원본 Feature와 파생 Feature
예를 들어 키와 몸무게가 있다고 하자.
Height
Weight
두 변수만으로도 모델을 만들 수 있지만, 체형을 더 직접적으로 표현하고 싶다면 BMI를 만들 수 있다.
BMI
= Weight / Height²
또 다른 예를 보면 다음과 같다.
구매금액 + 구매횟수
→ 평균 구매금액

주문일 + 배송완료일
→ 배송 소요시간

가입일 + 현재 날짜
→ 가입 기간
새로운 Feature는 단순한 계산 결과가 아니라 분석 문제를 더 정확히 표현하는 정보여야 한다.
3. EDA는 데이터에 질문하는 과정이다
EDA는 Exploratory Data Analysis, 즉 탐색적 데이터 분석이다.
EDA의 목적은 데이터를 처음부터 특정 결론에 맞추는 것이 아니라, 데이터의 구조와 특성을 살펴보고 문제와 가능성을 발견하는 것이다.
데이터 구조 이해
→ 데이터 품질 확인
→ 변수의 분포 확인
→ 변수 사이의 관계 탐색
→ 다음 전처리와 모델링 방향 결정
EDA는 단순히 차트를 여러 개 그리는 과정이 아니다.
데이터에 어떤 문제가 있으며, 어떤 정보를 더 만들어야 하는지 질문하는 과정이다.
EDA에서 얻은 결과는 이후 결측치 처리, 이상치 처리, 변수 변환과 Feature 생성 방향으로 연결된다.
EDA의 기본 흐름
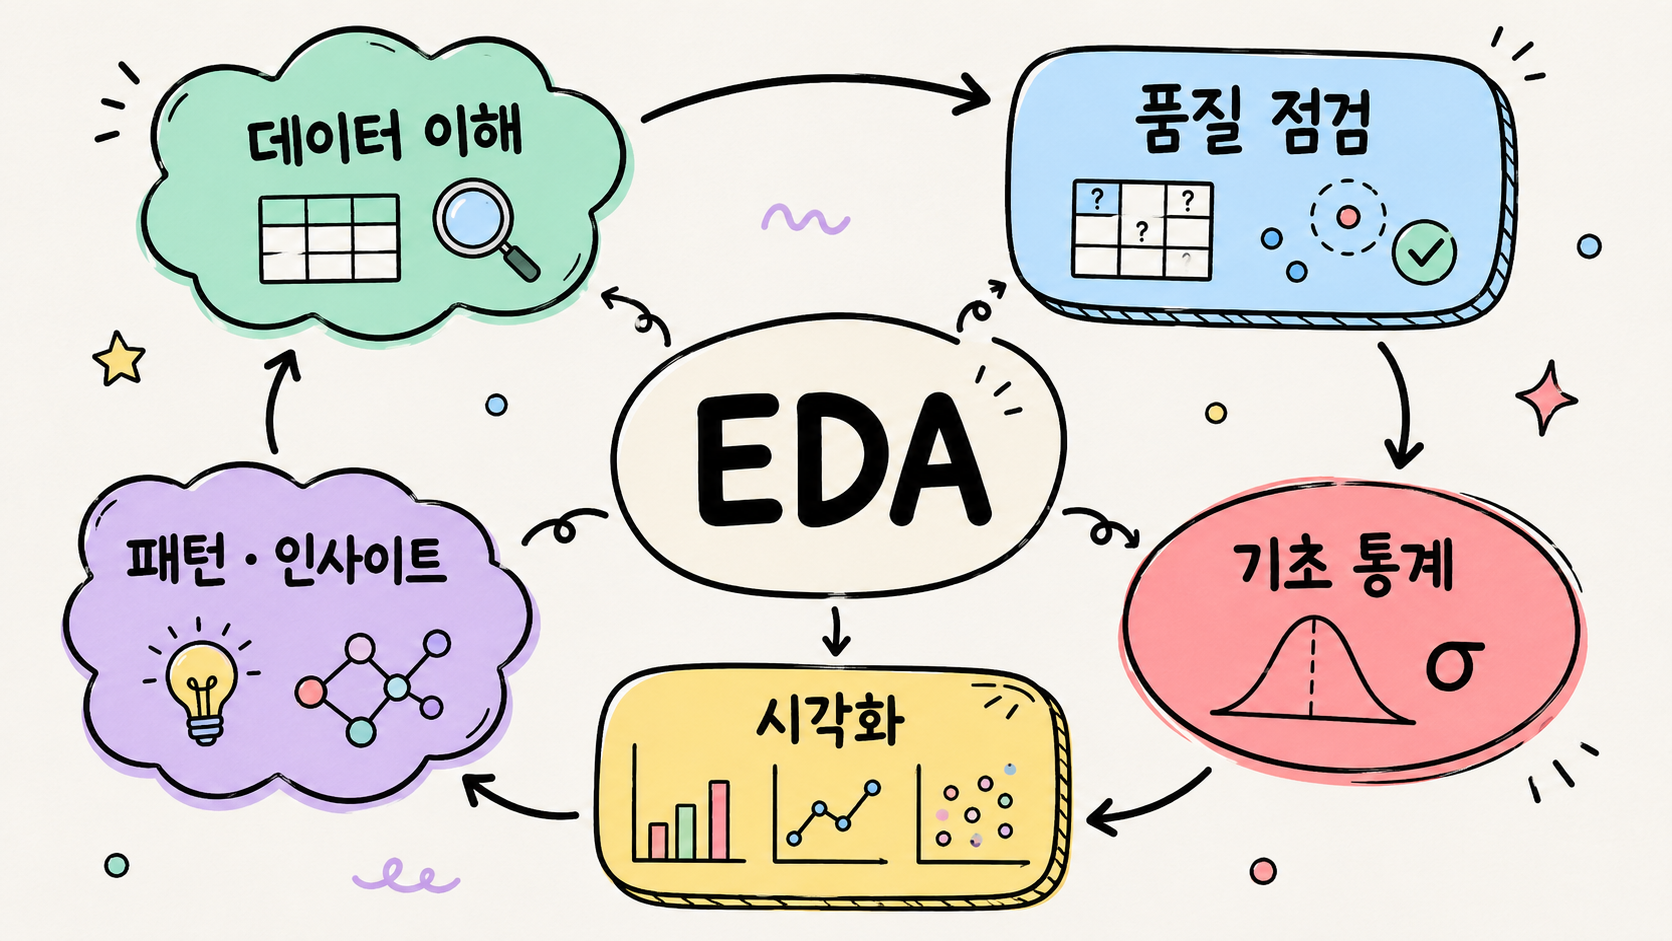
Raw Data
→ Structure
→ Statistics
→ Visualization
→ Question
→ Findings
→ Feature Engineering
→ Modeling
Structure
데이터의 형태와 타입을 확인한다.
print(df.shape)
print(df.columns)

df.info()
Statistics
데이터의 중심과 퍼짐을 확인한다.
df.describe()
df.describe(include="all")
Visualization
분포와 관계를 그래프로 확인한다.
Question
분석 목표에 맞는 질문을 만든다.
구매 고객과 미구매 고객의 연령 분포가 다른가?
급여가 높을수록 구매 확률이 증가하는가?
특정 부서의 구매율이 유난히 높은가?
Findings
발견한 문제와 패턴을 정리한다.
Age에 결측치가 존재함
Salary에 극단적으로 큰 값이 있음
Department의 범주별 빈도 차이가 큼
Salary와 Purchased 사이에 양의 관계가 있음
Next Action
발견한 내용에 따라 다음 작업을 결정한다.
결측치 대체
이상치 처리
범주 통합
변수 변환
새로운 Feature 생성
4. EDA 기본 Checklist
간단한 고객 데이터를 예로 들어보자.
import pandas as pd


df = pd.DataFrame({
    "Age": [
        25,
        32,
        None,
        41,
        28,
        35,
        50,
        22
    ],
    "Salary": [
        3200,
        4500,
        3900,
        5800,
        4100,
        6100,
        7200,
        3000
    ],
    "Department": [
        "HR",
        "IT",
        "Sales",
        "HR",
        "Sales",
        "IT",
        "IT",
        "HR"
    ],
    "Gender": [
        "F",
        "M",
        "F",
        "M",
        "F",
        "M",
        "M",
        "F"
    ],
    "Purchased": [
        0,
        1,
        0,
        1,
        0,
        1,
        1,
        0
    ]
})
데이터 구조 확인
print(df.shape)
print(df.columns)

df.info()
여기서는 다음 내용을 확인한다.
행과 열의 개수
컬럼 이름
컬럼별 데이터 타입
결측치가 존재하는 컬럼
숫자와 문자열 컬럼 구분
info()에서 Age의 non-null 수가 전체 행보다 적다면 결측치가 있다는 것을 알 수 있다.
데이터 미리보기
print(df.head())
print(df.tail())

print(
    df.sample(
        5,
        random_state=42
    )
)
head()만 확인하면 데이터가 특정 순서로 정렬되어 있을 때 전체 특성을 잘못 판단할 수 있다.
따라서 처음과 끝뿐 아니라 임의의 행도 함께 확인하는 것이 좋다.
기술통계 확인
print(
    df.describe()
)
수치형 변수에 대해 다음 값이 계산된다.
count
mean
std
min
25%
50%
75%
max
범주형 데이터까지 확인하려면 다음처럼 작성한다.
print(
    df.describe(
        include="all"
    )
)
범주형 변수에서는 고유값 수, 가장 자주 나온 값과 빈도를 확인할 수 있다.
기술통계는 중심 위치, 데이터의 퍼짐과 분포 형태를 빠르게 확인하기 위한 기본 단계다.
범주형 변수 확인
print(
    df["Department"].unique()
)

print(
    df["Department"].nunique()
)

print(
    df["Department"].value_counts()
)

print(
    df["Department"]
    .value_counts(
        normalize=True
    )
)
각 함수의 차이는 다음과 같다.
| 함수 | 의미 |
| unique() | 실제 고유값 목록 |
| nunique() | 고유값 개수 |
| value_counts() | 각 값의 등장 횟수 |
| value_counts(normalize=True) | 각 값의 비율 |
Cardinality
Cardinality는 범주형 변수에 존재하는 고유값의 수다.
Gender
→ 고유값 2개

Region
→ 고유값 5개

CustomerID
→ 고유값 100,000개
CustomerID처럼 각 행마다 값이 거의 다른 변수는 High Cardinality 변수다.
Cardinality가 높으면 One-Hot Encoding 시 컬럼이 지나치게 많이 만들어질 수 있다.
또한 고유값의 개수만 보고 변수의 의미를 판단해서는 안 된다.
CustomerID
→ 고유값이 많지만 일반적인 예측 Feature로
  직접 사용하는 것이 적절하지 않을 수 있음

Region
→ 고유값이 적고 실제 업무 의미가 있을 수 있음
범주형 변수는 고유값 개수와 함께 각 값의 빈도와 업무 의미를 살펴봐야 한다.
결측치 확인
missing_count = (
    df.isnull().sum()
)

missing_ratio = (
    df.isnull().mean()
)
print(missing_count)
print(missing_ratio)
isnull().sum()은 결측치 개수를, isnull().mean()은 결측치 비율을 보여준다.
컬럼이 많고 결측 패턴이 복잡하면 결측치 전용 시각화 도구를 이용해 다음 내용을 살펴볼 수도 있다.
특정 행에 결측치가 몰려 있는가?
여러 컬럼의 결측치가 함께 발생하는가?
특정 구간에서 반복적으로 결측되는가?
상관관계 확인
correlation = df.corr(
    numeric_only=True
)

print(correlation)
Heatmap으로 표현하면 변수 사이의 관계를 더 쉽게 비교할 수 있다.
import matplotlib.pyplot as plt
import seaborn as sns


sns.heatmap(
    correlation,
    annot=True,
    cmap="Blues"
)

plt.show()
상관관계가 높다고 해서 반드시 원인과 결과 관계가 있다는 의미는 아니다.
상관분석은 변수들이 비슷한 정보를 가지고 있는지, Target과 어떤 관계가 있는지를 탐색하기 위한 출발점으로 사용한다.
5. 변수 유형에 따라 그래프를 선택한다
EDA에서는 어떤 변수를 비교하느냐에 따라 적합한 그래프가 달라진다.
수치형 단일 변수
→ Histogram, KDE

범주형 단일 변수
→ Bar Chart, 빈도표

수치형과 수치형
→ Scatter Plot

수치형과 범주형
→ Box Plot

범주형과 범주형
→ 교차표, Mosaic Plot
수치형 단일 변수
수치형 변수의 분포는 Histogram으로 확인할 수 있다.
sns.histplot(
    data=df,
    x="Salary",
    kde=True
)

plt.show()
다음 내용을 살펴본다.
분포가 대칭적인가?
한쪽으로 긴 꼬리를 가지는가?
봉우리가 하나인가, 여러 개인가?
극단적인 값이 존재하는가?
데이터가 많다면 Histogram의 bins 값에 따라 그래프 모양이 달라질 수 있으므로 여러 구간 수를 비교하는 것이 좋다.
범주형 단일 변수
sns.countplot(
    data=df,
    x="Department"
)

plt.show()
범주가 많다면 그래프보다 빈도표가 더 읽기 쉬울 수 있다.
department_table = (
    df["Department"]
    .value_counts()
    .to_frame(
        "count"
    )
)

department_table["ratio"] = (
    department_table["count"]
    / len(df)
)
수치형과 수치형
두 수치형 변수의 관계는 Scatter Plot으로 확인한다.
sns.scatterplot(
    data=df,
    x="Age",
    y="Salary",
    hue="Purchased"
)

plt.show()
다음 내용을 살펴본다.
선형 관계인가?
곡선 형태의 비선형 관계인가?
관계가 강한가, 약한가?
이상치가 존재하는가?
그룹별 패턴이 다른가?
데이터가 너무 많아 점이 겹친다면 투명도나 Sampling을 사용할 수 있다.
수치형과 범주형
범주별 수치 분포는 Box Plot으로 확인한다.
sns.boxplot(
    data=df,
    x="Department",
    y="Salary"
)

plt.show()
Box Plot에서는 다음 정보를 확인할 수 있다.
범주별 중앙값
분포의 범위
사분위수
이상치 후보
범주별 관측치 차이
범주형과 범주형
두 범주형 변수는 교차표로 확인할 수 있다.
cross_table = pd.crosstab(
    df["Department"],
    df["Purchased"],
    normalize="index"
)

print(cross_table)
각 부서에서 구매와 미구매의 비율이 어떻게 달라지는지 확인할 수 있다.
수치형과 범주형 변수 조합에 따라 Histogram, Bar Chart, Scatter Plot, Box Plot과 교차표 등을 선택할 수 있다.
6. Question-driven EDA
EDA를 할 때 모든 그래프를 무작정 그리는 방식은 효율적이지 않다.
먼저 질문을 만들고, 질문에 맞는 분석을 수행한 뒤 다음 행동을 결정하는 방식이 좋다.
Question
→ Analysis
→ Finding
→ Next Action
예를 들면 다음과 같다.
| 질문 | 분석 | 다음 행동 |
| 결측치는 어디에 존재하는가? | 개수·비율·패턴 확인 | 삭제 또는 대체 |
| 중복값이 존재하는가? | Key와 전체 행 중복 확인 | 중복 제거 |
| 수치형 분포는 어떠한가? | 기술통계·Histogram | 변환·Scaling |
| 이상치가 존재하는가? | Box Plot·IQR·Z-score | 제거·대체 |
| 범주 빈도는 적절한가? | Cardinality·빈도표 | 범주 통합·Encoding |
| 유사한 변수가 존재하는가? | 상관관계·Heatmap | 변수 선택 |
Target과의 관계도 질문해야 한다.
Target이 수치형인 경우

수치형 변수가 증가하면 Target도 변하는가?
범주별 Target 평균에 차이가 있는가?
Target이 범주형인 경우

Target 그룹에 따라 수치형 변수 분포가 다른가?
범주에 따라 Target 비율이 달라지는가?
좋은 EDA는 그래프의 개수가 아니라, 분석 결과가 다음 전처리와 Feature 선택으로 연결되는지가 중요하다.
7. 결측치 처리
결측치는 값이 존재하지 않거나 사용할 수 없는 상태다.
Python과 Pandas에서는 주로 None, NA, NaN 형태로 표현된다.
결측치가 포함되면 다음 문제가 발생할 수 있다.
연산 수행 불가
모델 학습 오류
행 전체 삭제로 인한 데이터 손실
특정 그룹의 비율 왜곡
잘못된 통계량
결측치를 무조건 삭제하거나 평균값으로 채우는 방식은 적절하지 않다.
먼저 다음 질문을 해야 한다.
왜 값이 비어 있는가?
무작위로 발생한 결측인가?
특정 조건에서만 결측되는가?
결측 자체가 업무적인 의미를 가지는가?
결측치 제거
결측치 비율이 낮다면 해당 행을 제거하는 방법을 검토할 수 있다.
df_clean = df.dropna(
    subset=["Age"]
)
컬럼 대부분이 결측이라면 컬럼 제거를 고려할 수 있다.
df_clean = df.drop(
    columns=[
        "AlmostEmptyColumn"
    ]
)
단순한 검토 기준으로 다음과 같은 비율을 생각할 수 있다.
결측 행이 매우 적음
→ 행 제거 검토

특정 Feature의 절반 이상이 결측
→ 컬럼 제거 검토
하지만 데이터 수와 결측 원인, 변수의 중요도에 따라 판단이 달라져야 한다.
결측 비율이 높더라도 업무적으로 중요한 변수라면 바로 제거할 수 없다.
통계값으로 대체
수치형 변수는 평균이나 중앙값으로 대체할 수 있다.
df["Age"] = df[
    "Age"
].fillna(
    df["Age"].median()
)
범주형 변수는 최빈값으로 대체할 수 있다.
df["Department"] = df[
    "Department"
].fillna(
    df["Department"]
    .mode()[0]
)
평균은 이상치의 영향을 받을 수 있으므로 분포가 치우쳐 있다면 중앙값을 고려할 수 있다.
조건부 대체
전체 평균 대신 비슷한 그룹의 통계값을 사용할 수도 있다.
df["Age"] = (
    df.groupby(
        "Department"
    )["Age"]
    .transform(
        lambda values:
            values.fillna(
                values.median()
            )
    )
)
부서마다 연령 분포가 다르다면 전체 중앙값보다 부서별 중앙값이 더 적절할 수 있다.
시계열 결측치
시계열 데이터는 시간 순서가 중요하므로 일반적인 평균 대체가 적합하지 않을 수 있다.
이전 관측값 사용
이동평균 또는 이동중앙값
선형 보간
Spline 보간
time_series["value"] = (
    time_series["value"]
    .interpolate(
        method="linear"
    )
)
미래 값을 예측하는 시스템에서는 이전 값을 이용하는 방식이 더 보수적일 수 있다.
모델 기반 예측
결측되지 않은 다른 변수들을 이용해 결측값을 예측할 수도 있다.
회귀모델
KNN
기타 예측모델
다만 예측으로 만들어진 값도 실제 관측값은 아니다.
결측값 자체가 데이터의 Trend와 관련되어 있거나 예측모델의 성능이 낮다면 새로운 편향이 생길 수 있다.
결측치 처리는 제거, 통계값 대체, 조건부 대체와 모델 기반 예측 등으로 나눌 수 있다.
간단한 결측치 처리 함수
import pandas as pd


def handle_missing_values(
    data: pd.DataFrame
) -> pd.DataFrame:
    result = data.copy()

    result["Age"] = (
        result.groupby(
            "Department"
        )["Age"]
        .transform(
            lambda values:
                values.fillna(
                    values.median()
                )
        )
    )

    result["Department"] = (
        result["Department"]
        .fillna("Unknown")
    )

    return result
이 함수는 원본 DataFrame을 직접 수정하지 않고 복사본을 반환한다.
8. 이상치 탐지와 처리
이상치는 전체 데이터 범위에서 크게 벗어난 극단적인 관측치다.
정상 구매금액
→ 10,000원 ~ 500,000원

이상치 후보
→ 100,000,000원
이상치는 다음과 같은 원인으로 발생할 수 있다.
입력 오류
측정 장비 오류
단위 불일치
데이터 병합 오류
실제로 발생한 드문 사건
이상치는 평균과 분산을 크게 변화시키고, 모델이 일부 극단값에 지나치게 맞춰지게 만들 수 있다.
특히 회귀분석에서는 일부 이상치가 회귀선의 방향을 크게 바꿀 수 있다.
IQR 방식
IQR은 3사분위수와 1사분위수의 차이다.
IQR = Q3 - Q1
다음 범위를 벗어나는 값을 이상치 후보로 판단할 수 있다.
하한 = Q1 - 1.5 × IQR
상한 = Q3 + 1.5 × IQR
def find_iqr_outliers(
    series: pd.Series
) -> pd.Series:
    q1 = series.quantile(0.25)
    q3 = series.quantile(0.75)

    iqr = q3 - q1

    lower_bound = q1 - 1.5 * iqr
    upper_bound = q3 + 1.5 * iqr

    return (
        (series < lower_bound)
        | (series > upper_bound)
    )
outlier_mask = find_iqr_outliers(
    df["Salary"]
)

print(
    df.loc[outlier_mask]
)
IQR은 데이터의 중간 50% 범위를 이용하기 때문에 극단값의 영향을 비교적 적게 받는다.
Z-score 방식
Z-score는 각 값이 평균으로부터 표준편차 몇 배만큼 떨어져 있는지를 나타낸다.
Z-score
= (관측값 - 평균) / 표준편차
일반적으로 절댓값이 3보다 큰 값을 이상치 후보로 볼 수 있다.
from scipy.stats import zscore


salary_zscore = zscore(
    df["Salary"]
)

zscore_outlier = (
    abs(salary_zscore) > 3
)
IQR과 Z-score의 결과가 다를 수 있으므로 하나의 기준만 기계적으로 적용하기보다 두 방법과 시각화를 함께 사용할 수 있다.
이상치 제거
df_removed = df.loc[
    ~outlier_mask
].copy()
가장 간단한 방법이지만 실제로 의미 있는 극단값까지 삭제할 위험이 있다.
예를 들어 고액 구매 고객은 일반 고객과 크게 다른 값을 가지지만 분석 목적에 따라 가장 중요한 대상일 수도 있다.
이상치 값 제한
상한과 하한을 넘어간 값을 경계값으로 제한할 수 있다.
df["Salary_capped"] = (
    df["Salary"]
    .clip(
        lower=lower_bound,
        upper=upper_bound
    )
)
상한보다 큰 값
→ 상한값으로 변환

하한보다 작은 값
→ 하한값으로 변환
이 방식은 이상치라는 기록을 완전히 제거하지 않으면서 모델에 미치는 영향을 줄일 수 있다.
이상치 여부를 새로운 Feature로 사용하기
df["Salary_is_outlier"] = (
    outlier_mask.astype(int)
)
이상치가 업무적으로 의미가 있다면 값 자체를 삭제하기보다 이상치 여부를 별도 변수로 남길 수 있다.
Salary
→ 제한된 값 사용

Salary_is_outlier
→ 원래 값이 이상치였는지 기록
Log 변환
오른쪽 꼬리가 긴 양수 데이터는 Log 변환으로 큰 값을 압축할 수 있다.
import numpy as np


df["Salary_log"] = np.log1p(
    df["Salary"]
)
log1p()는 log(1 + x)를 계산하므로 0이 포함된 데이터에도 사용할 수 있다.
변수 변환은 2편의 고급 전처리에서 더 자세히 다룬다.
이상치 처리에서 중요한 판단
이상치가 발견되었다고 해서 바로 제거하면 안 된다.
이상치가 입력 오류인가?
실제로 발생 가능한 값인가?
업무적으로 중요한 사건인가?
Target과 관련된 의미 있는 신호인가?
특정 그룹에만 반복적으로 나타나는가?
예를 들어 부채비율, 금융 사기거래, 제조 불량과 같은 분석에서는 극단값 자체가 중요한 신호일 수 있다.
반대로 나이 355세처럼 불가능한 값은 입력 오류로 판단해 수정하거나 제거해야 한다.
이상치는 분석 분야와 발생 원인을 함께 고려해 처리해야 한다.
간단한 EDA와 전처리 예제
앞의 내용을 하나의 함수 흐름으로 연결할 수 있다.
import numpy as np
import pandas as pd


def inspect_data(
    data: pd.DataFrame
) -> None:
    print("Shape:", data.shape)
    print("\nColumns:")
    print(data.columns.tolist())

    print("\nInfo:")
    data.info()

    print("\nDescription:")
    print(
        data.describe(
            include="all"
        )
    )

    print("\nMissing Ratio:")
    print(
        data.isna().mean()
    )


def preprocess_customer_data(
    data: pd.DataFrame
) -> pd.DataFrame:
    result = data.copy()

    # 부서별 중앙값으로 연령 결측치 대체
    result["Age"] = (
        result.groupby(
            "Department"
        )["Age"]
        .transform(
            lambda values:
                values.fillna(
                    values.median()
                )
        )
    )

    # 급여 이상치 범위 계산
    q1 = result[
        "Salary"
    ].quantile(0.25)

    q3 = result[
        "Salary"
    ].quantile(0.75)

    iqr = q3 - q1

    lower_bound = q1 - 1.5 * iqr
    upper_bound = q3 + 1.5 * iqr

    # 이상치 여부 보존
    result["Salary_is_outlier"] = (
        ~result["Salary"].between(
            lower_bound,
            upper_bound
        )
    ).astype(int)

    # 이상치 영향 제한
    result["Salary"] = (
        result["Salary"]
        .clip(
            lower_bound,
            upper_bound
        )
    )

    return result
inspect_data(df)

processed_df = (
    preprocess_customer_data(df)
)

print(
    processed_df.head()
)
이 예제의 흐름은 다음과 같다.
데이터 구조 확인
→ 기술통계 확인
→ 결측치 비율 확인
→ 그룹별 중앙값 대체
→ IQR 이상치 탐지
→ 이상치 여부 Feature 생성
→ 극단값 제한
전체 흐름 다시 보기
비즈니스 문제
→ 분석 목표 정의

분석 목표
→ 필요한 데이터 정의

Raw Data
→ EDA

EDA
→ 구조·통계·분포·관계 확인

EDA Findings
→ 결측치와 이상치 발견

Missing Value
→ 삭제·통계 대체·조건부 대체·예측

Outlier
→ IQR·Z-score·시각화로 탐지

처리 결과
→ Scaling·Encoding·변수 변환
→ 새로운 Feature 생성
→ Modeling
핵심 정리
Feature Engineering
데이터를 모델이 학습하기 좋은
의미 있는 표현으로 바꾸는 과정
EDA
Structure
→ 데이터 형태와 타입

Statistics
→ 중심과 퍼짐

Visualization
→ 분포와 관계

Question
→ 분석 목적에 맞는 질문

Finding
→ 문제와 Insight 정리
결측치
원인과 패턴 확인
→ 삭제
→ 통계값 대체
→ 조건부 대체
→ 시계열 보간
→ 모델 기반 예측
이상치
IQR
Z-score
Box Plot
업무 기준
처리 방법
→ 제거
→ 경계값 제한
→ 변환
→ 가중치 조정
→ 이상치 여부 Feature 생성
EDA와 전처리에서 중요한 것은 정해진 공식을 무조건 적용하는 것이 아니다.
데이터에 문제가 있는 이유를 파악하고, 분석 목적과 업무 의미를 기준으로 어떤 정보를 보존하고 어떤 정보를 바꿀지 결정해야 한다.
결측치와 이상치는 단순한 오류일 수도 있지만, 경우에 따라 중요한 업무 신호일 수도 있다. 따라서 EDA를 통해 원인을 이해한 뒤 처리 방법을 선택해야 한다.
복습 질문
- 분석이 알고리즘 선택보다 비즈니스 이해에서 시작해야 하는 이유는 무엇인가?
- 데이터가 깨끗하다는 것만으로 좋은 모델을 만들기 어려운 이유는 무엇인가?
- Feature Engineering과 단순한 데이터 정제는 어떤 차이가 있는가?
- EDA에서 Structure, Statistics, Visualization과 Question은 각각 어떤 역할을 하는가?
- unique(), nunique()와 value_counts()는 어떻게 다른가?
- High Cardinality 변수를 바로 One-Hot Encoding하면 어떤 문제가 생길 수 있는가?
- 수치형 변수와 범주형 변수의 관계를 확인할 때 어떤 그래프가 적합한가?
- Question-driven EDA가 무작정 그래프를 그리는 방식보다 나은 이유는 무엇인가?
- 결측치를 삭제하기 전에 어떤 내용을 확인해야 하는가?
- 전체 평균보다 그룹별 중앙값으로 대체하는 것이 적합한 경우는 언제인가?
- 시계열 데이터의 결측치를 일반 평균으로 대체하기 어려운 이유는 무엇인가?
- IQR과 Z-score는 이상치를 어떤 기준으로 판단하는가?
- 이상치를 무조건 삭제하면 안 되는 이유는 무엇인가?
- 이상치 여부를 별도 Feature로 남기면 어떤 장점이 있는가?
- 분석 분야의 업무 지식이 결측치와 이상치 처리에 필요한 이유는 무엇인가?
'개발 > SKALA 4기' 카테고리의 다른 글
| [SKALA][Feature Engineering] Scaling·Encoding과 고급 전처리 정리 (0) | 2026.08.06 |
|---|---|
| [SKALA] 데이터 분석 및 Python 기초 ③: Pandas, 분석 자동화 (0) | 2026.08.06 |
| [SKALA] 데이터 분석 및 Python 기초 ① (0) | 2026.08.04 |
| [SKALA] 입력값 검증부터 Spring JPA와 API 문서화 (0) | 2026.07.31 |
| [SKALA] 컴포넌트 스캔과 Spring 컨테이너, HTTP 요청 바인딩 정리 (0) | 2026.07.29 |