지난 알고리즘 분석 기초에 이어, 이번 글에서는 데이터를 효율적으로 다루기 위한 뼈대인 '자료구조'의 기초 개념들을 정리해 보겠다.
특히 구체적인 코드로 구현하기 전에, 각 자료구조가 어떤 데이터를 가지고 어떤 연산을 수행하는지 논리적으로 정의하는 추상 데이터 타입에 대해 먼저 알아보자.
1. 추상 데이터 타입 (Abstract Data Type, ADT)
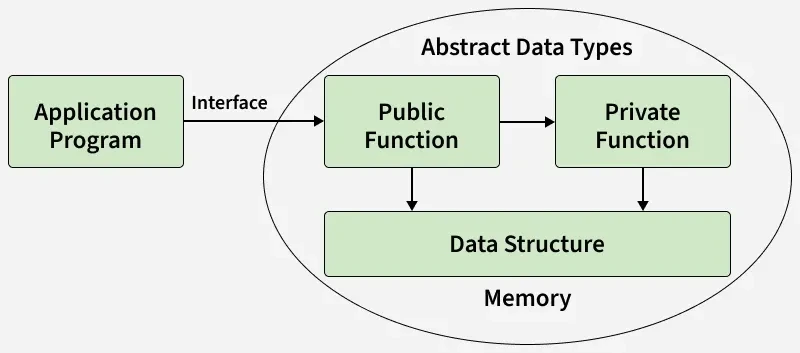
추상 데이터 타입(ADT)은 데이터 구조의 선언과 그 데이터를 다루는 연산(함수)의 정의를 하나로 묶어놓은 개념이다.
C++나 Java와 같은 객체지향 프로그래밍 언어에서는 주로 클래스(Class)라는 형태로 이 ADT를 구현한다.
우리가 알고리즘을 설계하고 그 알고리즘이 올바르게 동작하는지 증명할 때,
바로 이 ADT의 연산과 명세서를 바탕으로 논리를 전개하게 된다.
2. 스택(Stack)과 큐(Queue)
가장 기본이 되는 선형 자료구조 두 가지다. 데이터가 들어가고 나오는 위치와 순서에 차이가 있다.
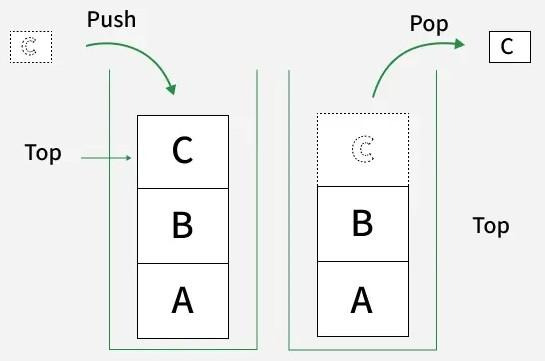
- 스택 (Stack): 한쪽 끝(Top이라고 부름)에서만 데이터의 삽입과 삭제가 일어나는 선형 구조다. 나중에 들어간 데이터가 가장 먼저 나오는 LIFO(Last In, First Out) 업데이트 방식을 따른다.
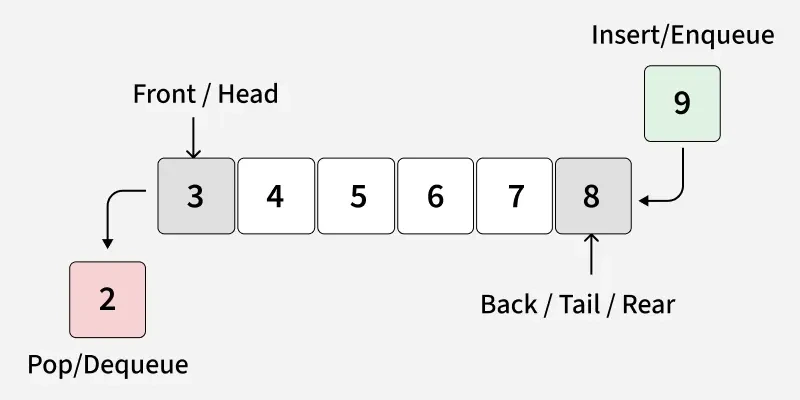
Queue - https://www.geeksforgeeks.org/dsa/introduction-to-queue-data-structure-and-algorithm-tutorials/ - 큐 (Queue): 스택과 달리 삽입은 뒤쪽(Rear 또는 Back)에서만 일어나고, 삭제는 앞쪽(Front)에서만 일어나는 선형 구조다. 먼저 들어간 데이터가 먼저 처리되는 FIFO(First In, First Out) 방식을 사용한다.
3. 이진 트리 (Binary Tree)와 우선순위 큐 (Priority Queue)
선형 구조에서 벗어나, 데이터의 계층이나 우선도를 표현할 때 사용하는 구조다.
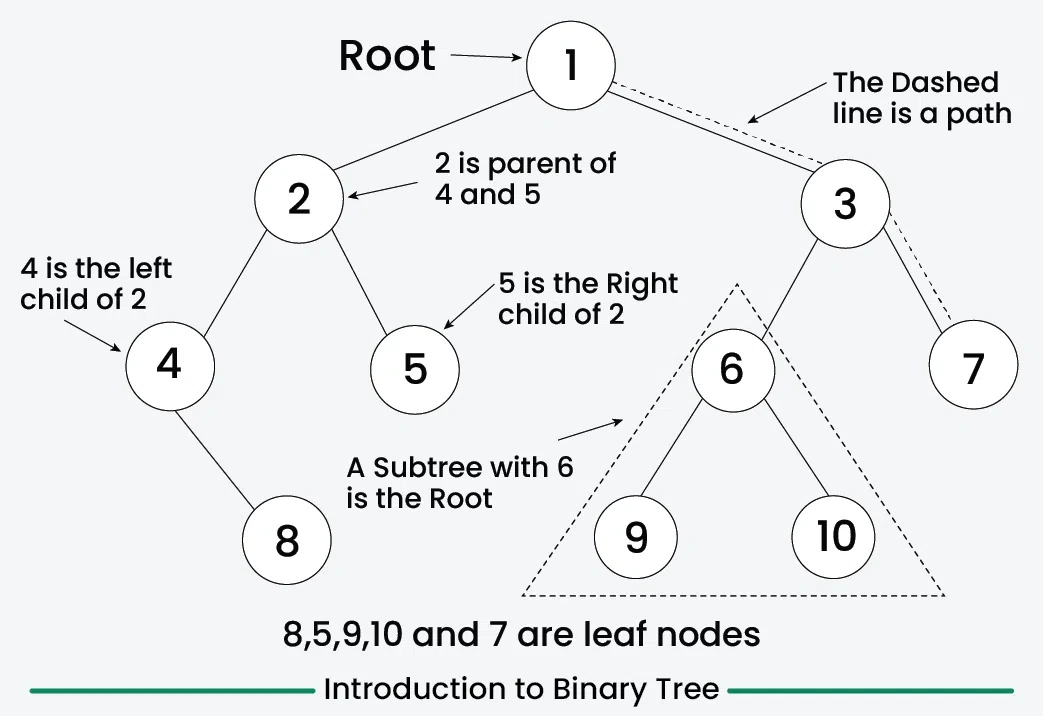
- 이진 트리 (Binary Tree): 노드(Node)라는 요소들로 구성되며, 가장 최상위에 루트(Root)라는 특별한 노드가 존재한다. 루트를 제외한 나머지 노드들은 왼쪽 서브 트리와 오른쪽 서브 트리라는 서로 겹치지 않는 두 개의 부분 집합으로 나뉘는 것이 특징이다.
- 이진 트리의 수학적 특성: 깊이가 d인 위치에는 최대 2^d개의 노드가 존재할 수 있다. 높이가 h인 트리가 가질 수 있는 최대 노드 수는 2^(h+1) - 1개다. 반대로 전체 노드가 n개일 때, 이 트리의 최소 높이는 log(n+1)의 올림 값에서 1을 뺀 값이 된다.
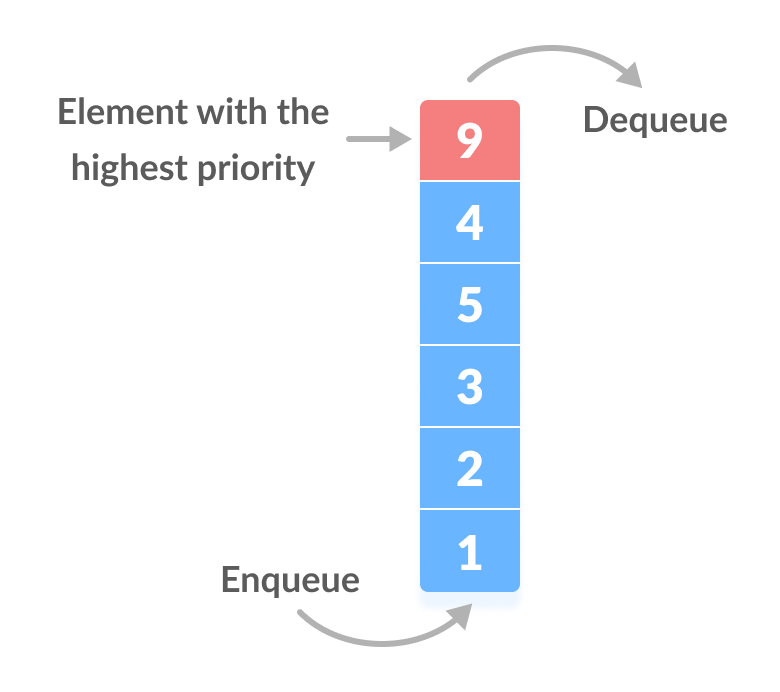
Priority Queue - https://www.programiz.com/dsa/priority-queue - 우선순위 큐 (Priority Queue): 기본적으로 큐의 형태를 띠지만, 데이터가 도착한 시간 순서가 아니라 각 요소가 가진 '우선순위'에 따라 순서가 결정되는 구조다. 현재 큐에 있는 요소 중 가장 중요한 요소를 먼저 확인하고 제거할 수 있다. 이때 우선순위의 기준은 상황에 따라 다르며, 비용(Cost) 관점에서는 가장 작은 값이, 이익(Profit) 관점에서는 가장 큰 값이 우선순위가 된다.
4. 유니온-파인드 (Union-Find)와 딕셔너리 (Dictionary)
데이터 간의 관계나 검색 효율을 위해 사용하는 ADT다.
- 유니온-파인드 (Union-Find): 겹치지 않는 서로소 집합(Disjoint Sets)을 다루기 위한 구조다. Union 연산은 겹치지 않는 두 개의 집합을 하나로 합치는 역할을 한다. Find 연산은 특정 요소의 현재 집합 ID를 찾아내는데, 보통 이 ID는 해당 집합을 대표하는 리더(Leader) 값이 된다. 주로 n개의 단일 집합을 만드는 create(n), 특정 요소의 집합 ID를 반환하는 find(sets, e), 단일 집합을 기존 집합에 넣는 makeSet(sets, e), 두 집합을 합치는 union(sets, s, t) 연산으로 구성된다.
- 딕셔너리 (Dictionary): 데이터를 식별자(Identifier)와 그 식별자에 연관된 정보의 쌍으로 저장하고 검색하는 연관 저장소 구조다. 이 구조 안에서 식별자들 사이에 별도의 순서가 정해져 있지는 않다는 것이 특징이다.
가장 기초적인 자료구조의 추상 데이터 타입을 이해하는 것은 효율적인 알고리즘 설계의 첫걸음이다.
앞으로는 이 기본 자료구조들이 어떻게 구체적인 코드로 구현되고 메모리에 저장되는지 정리해 보겠다.
'개발 > 알고리즘' 카테고리의 다른 글
| [공부][알고리즘] 다이내믹 프로그래밍(Dynamic Programing)과 행렬 연쇄 곱셈(Matrix-Chain Multiplication) (0) | 2026.05.19 |
|---|---|
| [공부][알고리즘] 힙(Heap) 구조의 이해와 활용 (0) | 2026.05.18 |
| [공부][알고리즘] 탐욕 알고리즘 (Greedy Algorithms) (0) | 2026.05.16 |
| [공부][알고리즘] 삽입 정렬(Insertion Sort) (0) | 2026.04.18 |
| [공부][알고리즘] 알고리즘 기본 개념 정리 (0) | 2026.04.18 |