컴퓨터 과학에서 수많은 데이터 중 가장 크거나 작은 값을 빠르게 찾아야 하는 상황은 빈번하게 발생한다.
이때 일반적인 배열이나 연결 리스트를 사용하면 데이터를 찾을 때마다 모든 요소를 뒤져야 하는 비효율이 발생한다.
이러한 문제를 획기적으로 해결하기 위해 고안된 자료구조가 바로 힙(Heap)이다.
오늘은 우선순위 큐나 다익스트라 알고리즘 등 핵심 기술의 뼈대가 되는 힙 자료구조에 대해 공부해보겠다.
1. 개념
힙은 최댓값이나 최솟값을 최상단에 빠르게 띄우기 위해 만들어진 완전 이진 트리 형태(Complete Binary Tree)의 자료구조다.
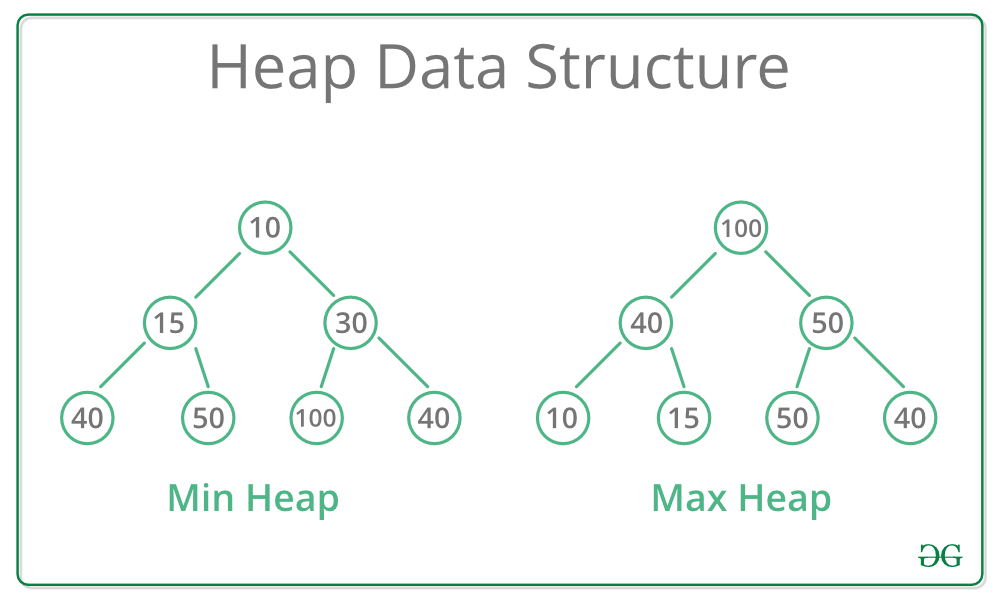
- 힙에는 부모 노드가 자식 노드보다 항상 크거나 같은 최대 힙과, 부모 노드가 자식 노드보다 항상 작거나 같은 최소 힙 두 가지 종류가 있다.
- 어떠한 형태든 힙은 항상 트리의 가장 꼭대기인 루트 노드에 전체 데이터 중 가장 우선순위가 높은 값을 유지한다는 뚜렷한 목적을 가진다.
2. 특징
힙의 기본 규칙은 다음과 같다.
- 부모 노드의 값은 항상 자식 노드의 값보다 크거나(최대 힙) 작아야(최소 힙) 한다.
- 트리의 모든 층이 왼쪽부터 차곡차곡 채워진 완전 이진 트리 형태여야 한다.
따라서 힙은 완전 이진 트리의 촘촘한 형태를 띠기 때문에
포인터로 얽힌 복잡한 트리 구조 대신 단순한 1차원 배열을 사용하여 빈틈없이 데이터를 저장할 수 있다.
배열의 인덱스를 활용하면 부모에 2를 곱해 왼쪽 자식을 찾고, 거기에 1을 더해 오른쪽 자식을 찾는 식으로 특정 노드의 위치를 단번에 계산할 수 있어 메모리와 속도 면에서 매우 효율적이다.
관계	공식
부모	(i - 1) // 2
왼쪽 자식	2 * i + 1
오른쪽 자식	2 * i + 2
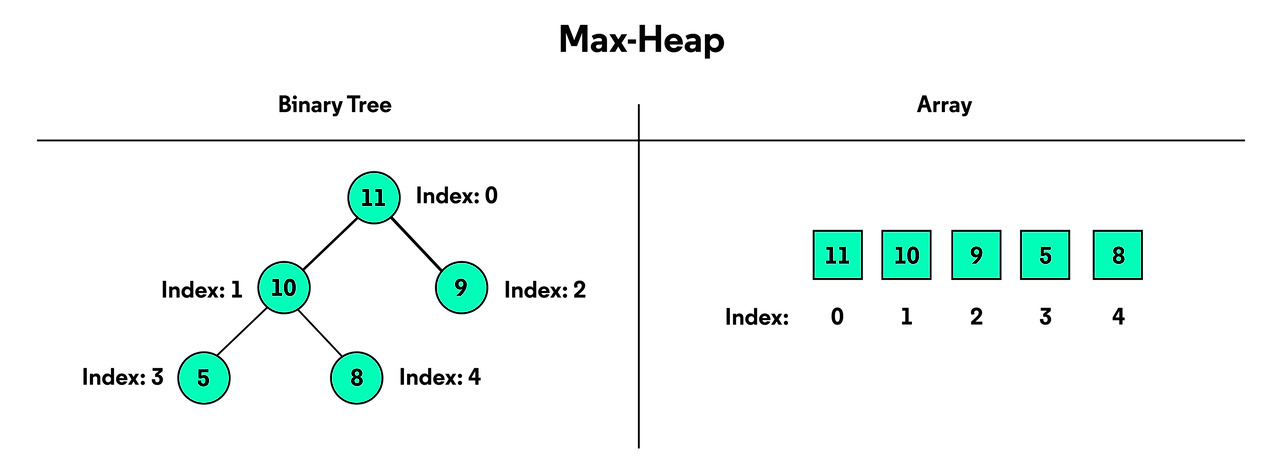
또한 형제 노드 간에는 대소 관계가 엄격하게 정해져 있지 않은 느슨한 정렬 상태를 유지한다.
데이터가 새롭게 삽입되거나 최상단 데이터가 삭제될 때만, 힙의 대소 관계 규칙을 복원하기 위해 노드들이 위아래로 자리를 바꾸는 재정렬 연산을 수행한다.
이를 바로 Heapify 라고 한다.
(말 그대로 힙화 된다고 이해하면 된다.)
예시
힙 자료구조가 수많은 데이터 속에서도 항상 가장 크거나 작은 값을 빠르게 찾아낼 수 있는 비결은 데이터가 들어오고 나갈 때마다 내부적으로 엄격한 규칙을 스스로 복원하기 때문이다. (Heapify)
이때 힙의 규칙을 유지하기 위해 노드들이 위아래로 자리를 바꾸며 이동하는 핵심 연산이 바로
버블 업(Bubble Up)과 버블 다운(Bubble Down)이다.
버블 업은 힙에 새로운 데이터가 추가될 때 발생하는 연산이다.
새로운 데이터는 항상 트리의 가장 맨 아래, 즉 배열의 맨 끝부분에 먼저 삽입되는데,
이 데이터가 자신의 크기에 맞는 올바른 위치를 찾기 위해 부모 노드와 비교하며 위로 거슬러 올라가는 과정을 말한다.
물속에서 가벼운 공기 방울이 수면 위로 떠 오르는 모습과 비슷하다고 하여 붙여진 이름이다.
반대로 버블 다운은 힙에서 가장 우선순위가 높은 루트 노드가 삭제될 때 발생하는 연산이다.
루트 자리가 비워지면 트리의 가장 마지막에 있던 노드를 루트 자리로 임시로 끌어올린다.
이후 이 노드가 자신의 크기에 맞는 자리를 찾기 위해 자식 노드들과 비교하며 아래로 가라앉는 과정을 버블 다운이라고 부른다.
두 연산의 가장 큰 특징은 전체 데이터를 모두 확인하지 않고 오직 자신의 직속 부모나 자식하고만 비교를 수행한다는 점이다.
버블 업은 자신의 부모 노드 단 하나와만 비교하면 되므로 진행이 매우 단순하다.
반면 버블 다운은 왼쪽 자식과 오른쪽 자식 두 개를 모두 확인해야 한다.
최소 힙이라면 두 자식 중 더 작은 값과 자리를 바꾸고, 최대 힙이라면 두 자식 중 더 큰 값과 자리를 바꾸며 내려간다.
이처럼 트리의 높이(레벨)를 따라 수직으로만 이동하기 때문에
데이터가 100만 개라도 단 20번 정도의 비교만으로 모든 재배열을 끝마칠 수 있는 완벽한 효율성을 자랑한다.
가장 큰 값을 최상단에 유지하는 최대 힙의 삽입(Push)과 삭제(Pop) 과정을 C++ 코드로 살펴보자.
1. 데이터 삽입 (Push)
새로운 데이터를 배열의 맨 끝에 추가한 뒤, 부모 노드와 비교하며 자신이 더 크다면 자리를 바꾸면서 위로 거슬러 올라간다.
#include <iostream>
#include <vector>
#include <algorithm>

using namespace std;

class MaxHeap {
private:
    vector<int> heap;

public:
    MaxHeap() {
        // 인덱스 계산을 쉽게 하기 위해 0번 인덱스는 사용하지 않음
        heap.push_back(0);
    }

    void push(int val) {
        heap.push_back(val); // 트리의 맨 마지막에 새로운 원소 추가
        int current = heap.size() - 1; // 새로 추가된 원소의 인덱스

        // 부모 노드와 비교하며 위로 올라감 (Bubble Up)
        // 현재 노드가 루트가 아니고, 현재 노드의 값이 부모 노드보다 크다면 스왑
        while (current > 1 && heap[current] > heap[current / 2]) {
            swap(heap[current], heap[current / 2]);
            current = current / 2;
        }
    }
위 코드를 바탕으로 기존 힙에 3이라는 작은 숫자가 새롭게 맨 밑바닥에 삽입되었다고 가정하자.
- 3은 자신의 직속 부모 노드를 확인한다.
- 만약 부모 노드의 값이 8이라면, 부모가 자식보다 작거나 같아야 한다는 최소 힙의 규칙이 깨진 것이다.
- 따라서 3과 8의 자리를 바꾼다.
- 한 칸 위로 올라간 3은 다시 새로운 부모 노드를 확인한다.
- 부모 노드가 1이라면 이번에는 규칙을 만족하므로 이동을 멈추고 그 자리에 정착한다.
2. 데이터 추출 및 삭제 (Pop)
루트 노드(최댓값)를 제거한 뒤, 루트 자리를 트리의 가장 마지막 원소로 채운다. 이후 자식 노드들과 비교하며 아래로 내려가는 과정을 거친다.
void pop() {
        if (heap.size() <= 1) return; // 힙이 비어있으면 종료

        // 루트 자리에 트리의 가장 마지막 원소를 가져옴
        heap[1] = heap.back();
        heap.pop_back(); // 가장 마지막 원소 제거

        int current = 1;

        // 자식 노드들과 비교하며 아래로 내려감 (Bubble Down)
        while (current * 2 < heap.size()) { // 왼쪽 자식이 존재할 때까지
            int leftChild = current * 2;
            int rightChild = current * 2 + 1;
            int nextPos = current;

            // 왼쪽 자식이 자신보다 크다면 후보로 선택
            if (heap[leftChild] > heap[nextPos]) {
                nextPos = leftChild;
            }
            // 오른쪽 자식이 존재하고, 오른쪽 자식이 왼쪽 자식이나 자신보다 더 크다면 후보 변경
            if (rightChild < heap.size() && heap[rightChild] > heap[nextPos]) {
                nextPos = rightChild;
            }

            // 자식들이 자신보다 작거나 같아서 교환할 필요가 없다면 (최대 힙 조건 만족) 반복 종료
            if (nextPos == current) break;

            swap(heap[current], heap[nextPos]);
            current = nextPos;
        }
    }

    int top() {
        if (heap.size() > 1) return heap[1];
        return -1; // 비어있을 경우 예외 처리
    }
};

int main() {
    MaxHeap maxHeap;
    maxHeap.push(10);
    maxHeap.push(30);
    maxHeap.push(20);
    maxHeap.push(50);

    cout << "최댓값: " << maxHeap.top() << "\n"; // 출력: 50
    maxHeap.pop();
    cout << "그 다음 최댓값: " << maxHeap.top() << "\n"; // 출력: 30

    return 0;
}
다음은 버블 다운 과정이다.
루트에 있던 최솟값을 빼내고, 맨 마지막에 있던 15라는 큰 숫자를 텅 빈 루트 자리로 가져왔다고 가정하자.
- 15는 자신의 왼쪽 자식(예: 5)과 오른쪽 자식(예: 9)을 확인한다.
- 최소 힙의 규칙을 복원하기 위해 자식 중 더 작은 숫자인 5를 선택하여 15와 자리를 바꾼다.
- 한 칸 아래로 내려간 15는 다시 새로운 두 자식을 확인한다.
- 자식들이 모두 자신보다 크거나 자신이 트리의 맨 바닥에 도달할 때까지 이 가라앉는 과정을 반복한다.
마무리
힙 자료구조는 단순히 최댓값과 최솟값을 빠르게 찾는 것을 넘어,
트리 구조의 논리적 이점과 배열의 물리적 효율성을 잘 결합한 결과물이다.
수백만 개의 데이터가 실시간으로 쏟아지는 복잡한 상황에서도 O(log n)이라는 놀라운 속도로 데이터의 우선순위를 흔들림 없이 유지할 수 있다.
이러한 독보적인 안정성과 효율성 덕분에 힙은 운영체제의 작업 스케줄링, 네트워크 라우터의 트래픽 제어, 다익스트라 최단 경로 탐색 등 다양한 시스템과 알고리즘의 심장부에서 핵심적인 역할을 수행한다.
단순한 1차원 배열로 이렇게 강력한 성능을 내는 자료구조는 흔치 않다.
운영체제의 작업 스케줄링이나 최댓값을 지속적으로 관리해야 하는 문제에서 최대 힙은 필수적으로 사용되므로, 그 동작 원리와 구현 방법을 확실히 익혀두는 것이 중요하다.
'개발 > 알고리즘' 카테고리의 다른 글
| [공부][알고리즘] 다이내믹 프로그래밍(Dynamic Programing)과 행렬 연쇄 곱셈(Matrix-Chain Multiplication) (0) | 2026.05.19 |
|---|---|
| [공부][알고리즘] 탐욕 알고리즘 (Greedy Algorithms) (0) | 2026.05.16 |
| [공부][알고리즘] 삽입 정렬(Insertion Sort) (0) | 2026.04.18 |
| [공부][알고리즘] 추상 데이터 타입(ADT)과 기본 자료구조 (0) | 2026.04.18 |
| [공부][알고리즘] 알고리즘 기본 개념 정리 (0) | 2026.04.18 |