알고리즘을 공부하다 보면 가장 먼저 마주치는 정렬 중 하나가 바로 삽입 정렬이다.
오늘은 핵심 정렬 알고리즘 중 첫 번째인 삽입 정렬의 개념과 세부적인 동작 메커니즘, 복잡도, 그리고 이것이 왜 특정 조건 하에서는 수학적으로 optimal인지 분석해보겠다.
1. 개념
삽입 정렬은 말 그대로 새로운 데이터를 이미 정렬된 구간의
알맞은 위치에 삽입하며 정렬을 완성해 나가는 알고리즘이다.
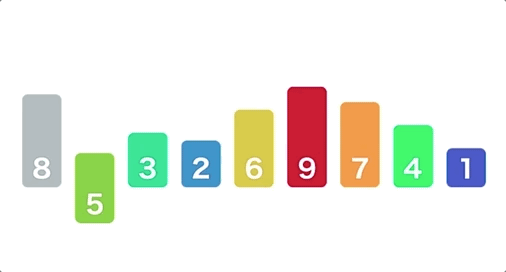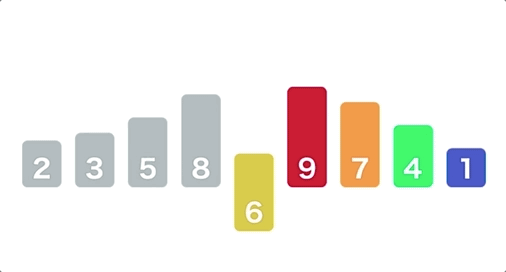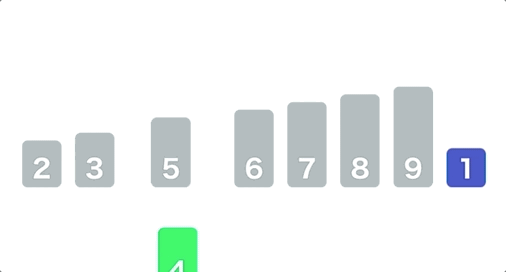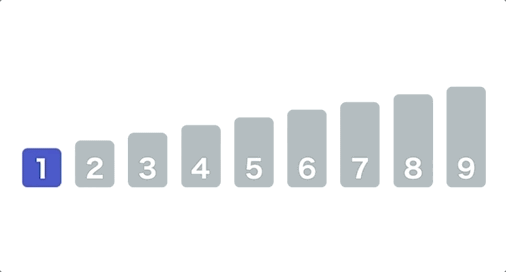
처음에는 배열의 첫 번째 요소 하나만이 정렬된 구간이라고 가정하고 시작한다.
이후 두 번째 요소부터 마지막 요소까지 차례대로 꺼내어 앞쪽의 정렬된 구간과 비교하면서 자신의 자리를 찾아가는 직관적인 방식을 사용한다.
2. 내부 동작 원리
임의의 순서로 나열된 n개의 요소가 있는 배열을 정렬한다고 생각해보자.
정렬된 구간의 바로 다음에 있는 요소 x를 선택한다.
이 요소 x를 잠시 다른 곳으로 빼두어 원래 있던 자리를 빈자리로 만든다. 그리고 이 x를 빈자리 바로 왼쪽에 있는 정렬된 요소와 반복해서 비교한다.
만약 왼쪽 요소가 x보다 크다면 그 요소를 빈자리로 이동시킨다. 그러면 자연스럽게 빈자리는 한 칸 앞으로 이동하게 된다.
반대로 왼쪽 요소가 x보다 작거나 더 이상 비교할 요소가 없다면, x를 현재의 빈자리에 쏙 집어넣는다.
추가적인 배열을 새로 만들지 않고 원래 배열 안에서 요소들만 이리저리 이동하는 전형적인 제자리 정렬 방식이다.
C++코드로 구현하면 다음과 같다.
#include <iostream>
#include <vector>

void insertionSort(std::vector<int>& arr) {
    int n = arr.size();

    for (int i = 1; i < n; i++) {
        int key = arr[i];
        int j = i - 1;

        while (j >= 0 && arr[j] > key) {
            arr[j + 1] = arr[j];
            j--;
        }

        arr[j + 1] = key;
    }
}

int main() {
    std::vector<int> data = {12, 11, 13, 5, 6};

    insertionSort(data);

    for (int num : data) {
        std::cout << num << " ";
    }
    std::cout << "\n";

    return 0;
}
위 함수 코드에서 for 루프는 정렬되지 않은 원소들을 하나씩 선택하는 역할을 하고, 내부의 while 루프는 정렬된 구간 안에서 원소들을 뒤로 밀어내며 알맞은 빈자리를 찾는 역할을 수행한다.
앞서 다룬 내용처럼 데이터가 거의 정렬되어 있다면 while 루프의 조건이 금방 거짓이 되어 바로 종료되므로 매우 빠른 속도를 보여준다.
3. 복잡도 분석
수학적인 잣대로 이 알고리즘이 얼마나 많은 연산을 하는지 비교 횟수를 기준으로 측정해 볼 수 있다.
최악의 경우 배열이 완전히 역순으로 정렬되어 있는 최악의 상황을 가정해 보자.
매번 정렬된 구간의 맨 끝에서부터 맨 앞까지 모든 요소와 비교하며 빈자리를 밀어내야 한다.
n-1번의 단계를 거치면서 비교 횟수가 누적되므로 계산식은 W(n) = n(n-1)/2가 된다.
입력 데이터 크기 n의 제곱에 비례하여 시간이 증가하므로 점근적 표기법으로는 Θ(n^2) 알고리즘으로 분류된다.
평균적인 경우 데이터가 무작위로 섞여 있어 요소가 들어갈 위치가 평균적으로 정렬된 구간의 중간쯤이라고 가정해 보자.
평균 비교 횟수 A(n)을 산출해 보면 대략 n^2/4로 수렴한다.
상수값 4로 나누어지긴 하지만 여전히 최고차항이 n^2이므로 시간 복잡도는 변함없이 Θ(n^2)이 된다.
4. 수학적 최적성과 한계
배열 내에서 큰 요소가 작은 요소보다 앞에 위치하여 순서가 꼬여있는 상태를 역전이라고 부른다.
단순히 키값을 비교하면서 한 번 비교할 때마다 최대 하나의 역전만을 제거할 수 있는 정렬 알고리즘은 필연적으로 최악의 경우 최소 n(n-1)/2 번, 평균적으로 최소 n(n-1)/4 번의 비교 연산을 수행해야만 한다.
놀랍게도 삽입 정렬의 비교 횟수는 이 수학적 하한선과 정확히 일치한다.
즉, 오직 인접한 요소끼리만 자리를 바꾸며 국소적으로 정렬을 수행하는 알고리즘 생태계 안에서는 삽입 정렬이 더 이상 비교 횟수를 줄일 수 없는 가장 최적인 알고리즘이라는 뜻이다.
물론 이것이 현존하는 모든 정렬 알고리즘 중 최고라는 의미는 결코 아니며, 인접 교환 방식 자체가 가진 태생적 한계를 명확히 보여주는 정리이기도 하다.
'개발 > 알고리즘' 카테고리의 다른 글
| [공부][알고리즘] 다이내믹 프로그래밍(Dynamic Programing)과 행렬 연쇄 곱셈(Matrix-Chain Multiplication) (0) | 2026.05.19 |
|---|---|
| [공부][알고리즘] 힙(Heap) 구조의 이해와 활용 (0) | 2026.05.18 |
| [공부][알고리즘] 탐욕 알고리즘 (Greedy Algorithms) (0) | 2026.05.16 |
| [공부][알고리즘] 추상 데이터 타입(ADT)과 기본 자료구조 (0) | 2026.04.18 |
| [공부][알고리즘] 알고리즘 기본 개념 정리 (0) | 2026.04.18 |